Incident Response: qué es y qué hace un equipo de respuesta a incidentes
A las dos de la madrugada aparece una alerta crítica en el EDR: un servidor de producción ejecuta comandos anómalos. ¿Aislar de inmediato o seguir observando para conocer el alcance del atacante? Incident Response es la disciplina de tomar decisiones rápidas y coordinadas bajo incertidumbre para contener el daño y recuperar la operación. En esta guía desglosamos el nuevo modelo NIST SP 800-61 Rev. 3, el papel del CSIRT, la preservación de evidencia digital (DFIR) y cómo construir un proceso resiliente.
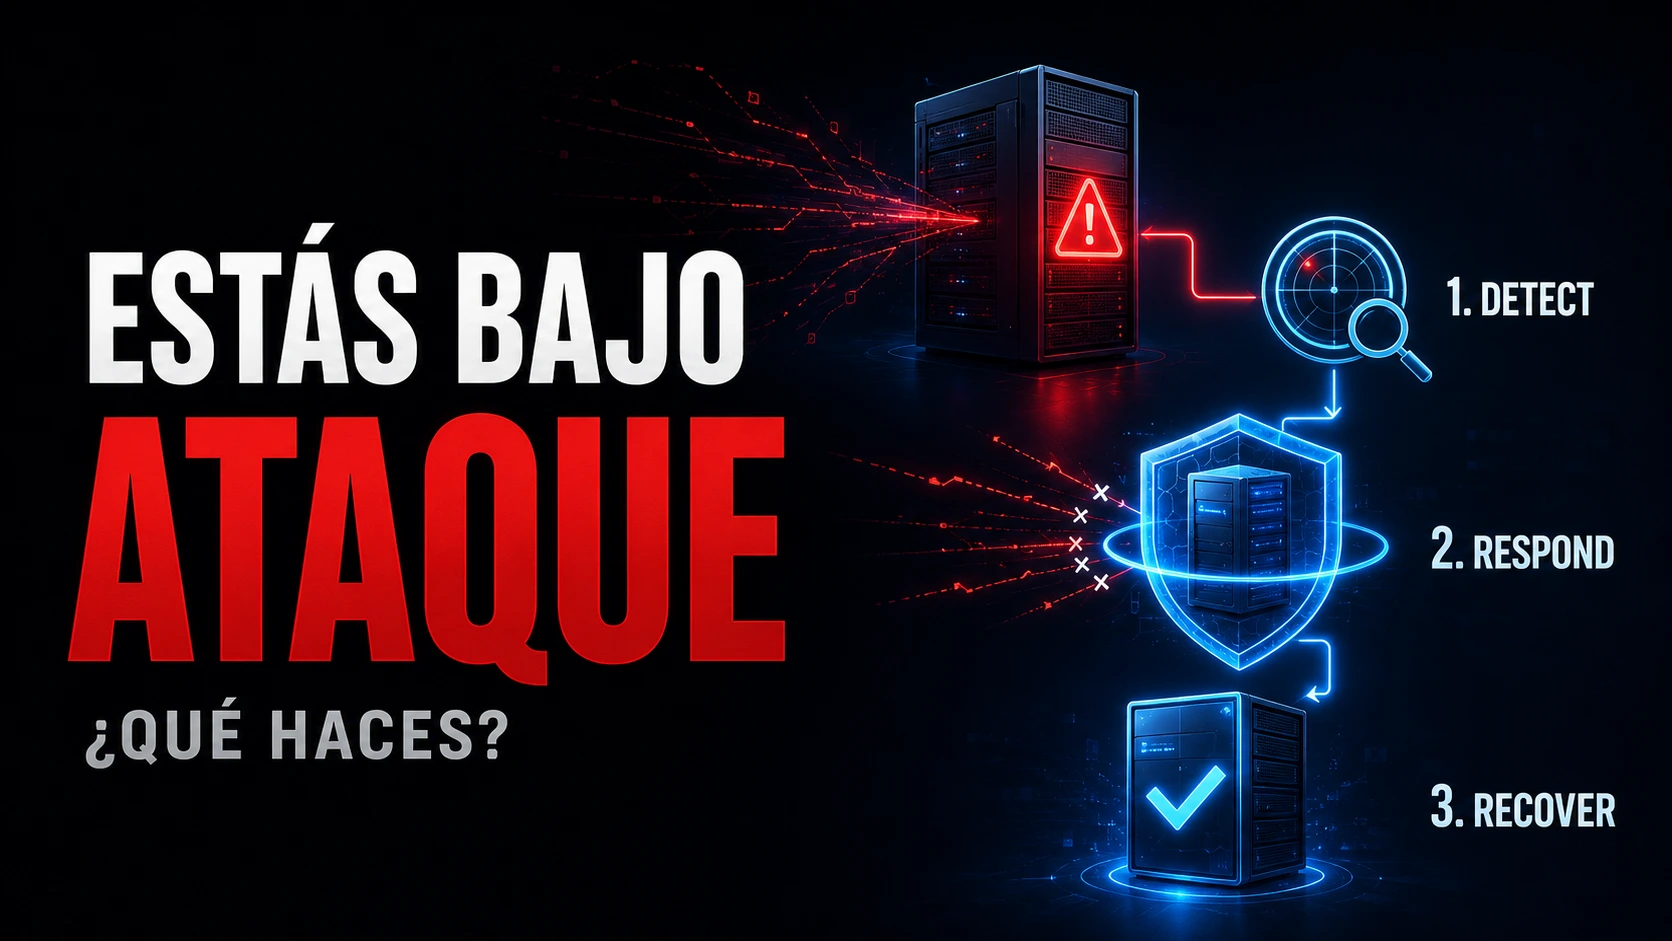
Respuesta rápida: ¿qué es Incident Response? #
Incident Response (Respuesta a Incidentes) es la capacidad organizada y estructurada de una empresa para detectar, clasificar, contener, erradicar y recuperarse de ciberataques e incidentes de seguridad, minimizando el impacto en las operaciones del negocio y aprendiendo de lo ocurrido para prevenir futuras brechas.
Para entender cómo se orquestan las alertas previas, consulta nuestra guía sobre SIEM vs SOAR y el mapa competencial de habilidades de analista SOC.
Protocolo paso a paso para contener brechas, aislar amenazas, preservar evidencias y recuperar la operatividad empresarial de forma segura.
Evento, alerta, incidente y brecha: diferencias clave #
- Evento: Suceso observable en un sistema (un inicio de sesión, una conexión de red).
- Alerta: Notificación generada cuando un evento o patrón coincide con una regla de detección sospechosa.
- Incidente: Evento adverso que compromete o amenaza directamente la confidencialidad, integridad o disponibilidad de los sistemas.
- Brecha de datos (Data Breach): Incidente confirmado que resulta en la destrucción, pérdida, alteración o divulgación no autorizada de datos personales o confidenciales (con implicaciones legales bajo RGPD).
El nuevo modelo NIST SP 800-61 Rev. 3 (CSF 2.0) #
La publicación de NIST SP 800-61 Rev. 3 actualizó el clásico modelo de 4 fases para integrarlo orgánicamente con el Cybersecurity Framework (CSF 2.0). La respuesta a incidentes ya no se concibe como un proceso aislado, sino como un ciclo operativo soportado por la gobernanza y la preparación continua del riesgo.
El Marco Integrado de Respuesta
- Base Preparatoria: GOVERN + IDENTIFY + PROTECT (autoridad, inventario de activos y hardening).
- Ciclo Operativo: DETECT → RESPOND → RECOVER (detección, contención activa y restauración).
- Retroalimentación: IMPROVEMENT (lecciones aprendidas para elevar la resiliencia futura).
Fase previa: GOVERN, IDENTIFY y PROTECT #
Una respuesta eficaz depende de lo que se configuró meses antes del ataque. La gobernanza define quién tiene la autoridad legal y ejecutiva para aislar un servidor crítico; la identificación mantiene un inventario claro de activos; y la protección garantiza la existencia de telemetría y logs suficientes en sistemas Windows, Linux y redes (incluyendo capturas de paquetes analizables con Wireshark) para poder investigar.
DETECT y Triage: evaluando el impacto inicial #
El triage de alertas SOC evalúa metódicamente la severidad, el alcance y la veracidad de la señal para separar falsos positivos de amenazas confirmadas antes de activar la maquinaria de respuesta. Al declarar formalmente un incidente se activan los canales de comunicación seguros, los roles de guardia y la preservación estricta de registros.
RESPOND: investigación y determinación del alcance #
Antes de actuar precipitadamente es imprescindible construir una cronología exhaustiva (timeline): vector de acceso inicial, ejecución de procesos, movimientos laterales y persistencia, mapeando la actividad contra las técnicas MITRE ATT&CK identificadas. La meta no es solo limpiar la primera máquina infectada, sino descubrir la totalidad de activos comprometidos por el adversario.
El dilema de la contención: aislar vs. observar #
| Estrategia | Ventajas | Riesgos |
|---|---|---|
| Aislamiento Inmediato | Corta la propagación lateral y la exfiltración de datos. | Destruye conexiones activas y alerta al atacante si mantiene otros accesos. |
| Observación Controlada | Permite identificar toda la infraestructura del adversario. | Riesgo de que el atacante despliegue ransomware o borre evidencias. |
Preservación de evidencia digital (DFIR) #
DFIR (Digital Forensics and Incident Response) une la contención operativa con la adquisición rigurosa de evidencia forense (volcado de memoria RAM, copias bit a bit de disco y preservación de marcas de tiempo). La cadena de custodia es vital si el incidente deriva en litigio o denuncia judicial.
Erradicación y comunicación en crisis #
La erradicación elimina la causa raíz: desinfección de malware, rotación de credenciales de dominio, parcheo de vulnerabilidades y cierre de puertas traseras. Paralelamente, el equipo debe gestionar la comunicación fuera de banda (out-of-band) si los correos corporativos habituales están bajo sospecha.
RECOVER: restauración segura y no solo encender #
Restaurar una copia de seguridad sin haber parcheado la vulnerabilidad inicial provoca que el atacante vuelva a comprometer el sistema en minutos. La recuperación debe ser gradual y monitorizada, verificando que los backups están libres de persistencia oculta.
Mejora continua y lecciones aprendidas #
La reunión post-incidente (Post-Mortem) analiza objetivamente qué falló en la detección, qué decisiones sufrieron retrasos y qué lagunas de telemetría existieron, transformando cada brecha en un plan de hardening y nuevas reglas de detección.
Roles en un equipo CSIRT / IRT #
Composición Multidisciplinar del CSIRT
- Incident Commander: Lidera la coordinación global, gestiona tiempos y toma decisiones estratégicas.
- Analistas SOC / Blue Team: Analizan telemetría en SIEM y EDR (guía SOC).
- Especialistas Forenses: Adquieren y analizan memoria y artefactos de disco.
- Administradores de Sistemas / Redes: Ejecutan cambios de firewall, aislamiento de VLANs y soporte a sistemas.
- Legal, Privacidad y DPO: Evalúan obligaciones regulatorias y notificación de brechas a las autoridades.
Plan, Playbook y Runbook: operacionalizar la respuesta #
- Incident Response Plan (IRP): Política de alto nivel que define la estructura del CSIRT, criterios de severidad y flujos de escalado.
- Playbook: Procedimiento específico para un escenario de amenaza (ej. cómo responder específicamente a un incidente de ransomware o nuestro análisis de BEC y phishing).
- Runbook: Guía técnica paso a paso con comandos exactos para ejecutar una tarea (ej. aislar un host en el EDR o revocar tokens en Azure AD).
Si quieres pasar del concepto al procedimiento operativo, consulta nuestra guía especializada sobre cómo crear playbooks de respuesta a incidentes con criterios de activación, roles, decisiones, contención y ejercicios Tabletop.
Simulaciones Tabletop y métricas de respuesta #
Los Tabletop Exercises son simulaciones guiadas donde el equipo técnico y la dirección resuelven un ataque ficticio sobre una mesa de trabajo para detectar lagunas en los planes. Las métricas operativas clave incluyen MTTD (tiempo medio de detección), MTTA (tiempo de triaje) y MTTR (tiempo medio de resolución/recuperación).
Ruta profesional y conclusión #
Para trabajar en respuesta a incidentes, practica recreando escenarios en tu propio home lab de ciberseguridad y documenta informes ejecutivos para tu portfolio. Consulta nuestro Blue Team roadmap y el catálogo de formación en ciberseguridad para dominar las habilidades defensivas más demandadas.
Cursos recomendados para tu formación
Formaciones técnicas estructuradas para avanzar desde fundamentos hasta respuesta a incidentes.
Plan de Rescate Digital: Cómo Actuar Frente a un Ciberataque
Cómo actuar frente a un ciberataque. Protocolo paso a paso de contención.
Ver curso
Automatización de Ciberseguridad con n8n e IA: SIEM y SOAR
Defensa activa, integración de flujos de análisis de alertas y respuesta ante incidentes automatizada con IA.
Ver curso
Seguridad Informática para Principiantes: Empieza desde 0 Ya
Bases de informática, sistemas, usuarios y conceptos esenciales para arrancar sin tecnicismos complejos.
Ver curso
Fundamentos de Redes: Cómo se realizan las Comunicaciones
Modelo TCP/IP, puertos, direccionamiento IP, protocolos y análisis de paquetes indispensable.
Ver curso
CompTIA Security+ SY0-701: Práctica + Examen Completo
El estándar internacional de ciberseguridad: amenazas, arquitectura de control y gestión de incidentes.
Ver curso
Hacking Ético Ofensivo. 100% Practico en Red Team. +43hs
100% práctico. Más de 43 horas de contenido exhaustivo para el rol ofensivo.
Ver curso