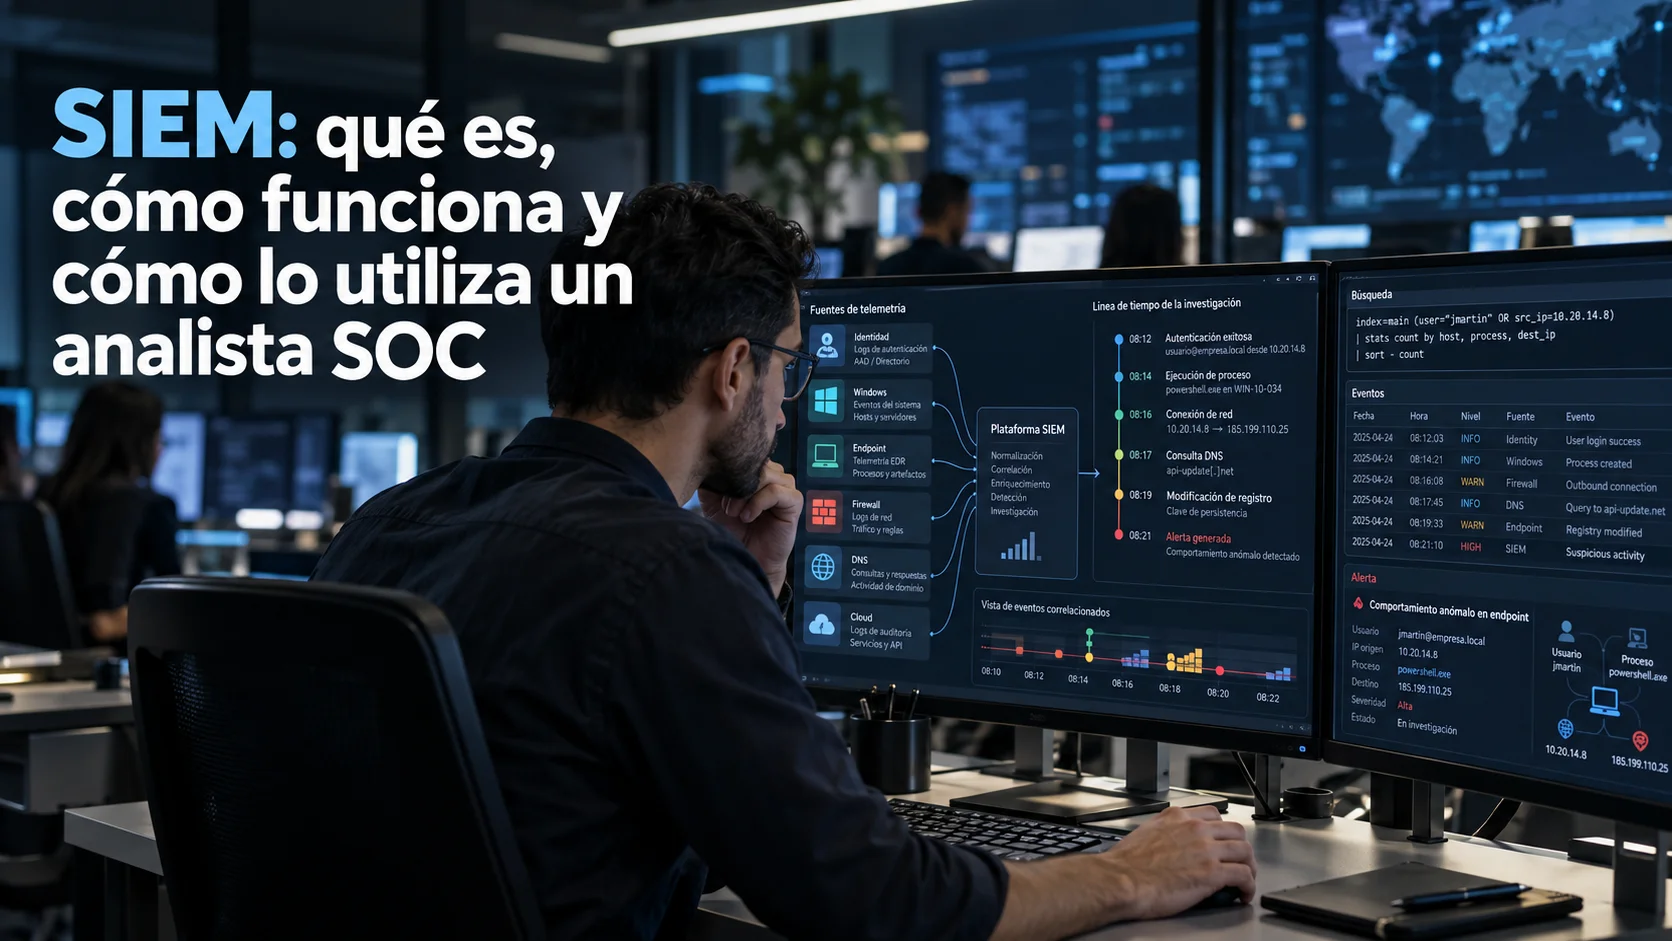
Respuesta rápida: ¿qué es un SIEM y cuál es su función en un SOC? #
Un SIEM (Security Information and Event Management) es una plataforma centralizada diseñada para recopilar, normalizar, almacenar y analizar eventos de seguridad y telemetría generados por múltiples sistemas independientes (endpoints, servidores, cortafuegos, directorios activos y servicios cloud). Su objetivo no es almacenar registros de manera estática, sino permitir que los analistas del SOC ejecuten consultas rápidas, correlacionen eventos entre fuentes heterogéneas, disparen reglas analíticas de detección y gestionen incidentes de seguridad.
El ciclo operativo de un SIEM transforma datos dispersos en decisiones forenses respaldadas por evidencia técnica:
Esta guía profundiza en la arquitectura interna y la metodología de análisis en el SIEM. Si necesitas comprender las diferencias con plataformas de automatización y orquestación, consulta nuestra comparativa entre SIEM vs SOAR. Para dominar las fuentes de entrada base, revisa nuestra guía sobre logs de seguridad y cómo analizarlos.
Un controlador de dominio registra varios intentos fallidos de autenticación.
El firewall observa una conexión desde una dirección externa.
El endpoint registra la ejecución de PowerShell.
El servidor DNS muestra una consulta hacia un dominio que ese equipo corporativo nunca antes había utilizado.
Cada sistema observó una parte distinta de la realidad.
El problema es que ninguno conoce la historia completa.
Ahí empieza a tener sentido un SIEM:
WINDOWS ───────────┤
LINUX ─────────────┤
FIREWALL ──────────┤
DNS ───────────────┼──► SIEM ─► búsqueda ─► detección ─► investigación
EDR ───────────────┤
VPN ───────────────┤
CLOUD ─────────────┤
APLICACIONES ──────┘
El SIEM no existe simplemente para guardar logs en un disco duro.
Su verdadera utilidad aparece cuando podemos utilizar telemetría de fuentes diferentes para responder preguntas que ninguna de ellas podría contestar por separado.
1. Qué es un SIEM: definición técnica y evolución #
Las siglas SIEM responden a Security Information and Event Management (Gestión de Información y Eventos de Seguridad). Históricamente, el término surgió de la combinación de dos disciplinas acuñadas por analistas del sector:
- SIM (Security Information Management): Enfocado en el almacenamiento a largo plazo, el análisis de tendencias, la generación de informes y el cumplimiento normativo (compliance).
- SEM (Security Event Management): Centrado en la monitorización en tiempo real, el procesamiento inmediato de eventos y la notificación de alertas ante incidencias técnicas.
Una plataforma SIEM moderna unifica ambas vertientes para recolectar y analizar telemetría masiva procedente de entornos distribuidos, resolviendo tareas operativas esenciales:
- Búsqueda y consulta ad-hoc: Capacidad de interrogar miles de millones de eventos en segundos mediante motores de indexación especializados.
- Monitorización continua: Visualización del estado defensivo de la red y seguimiento de activos críticos.
- Detección analítica y reglas: Ejecución recurrente de lógica booleana, secuencias o umbrales para identificar anomalías.
- Correlación entre fuentes: Unión de registros de identidad, perímetro, puesto de trabajo y nube vinculados a una misma entidad.
- Generación y triaje de alertas: Emisión de avisos con contexto enriquecido para su priorización defensiva.
- Investigación forense y Threat Hunting: Exploración retrospectiva y proactiva de rastros de intrusión.
- Conservación y custodia de evidencias: Almacenamiento estructurado para auditorías y requerimientos legales.
Los productos de última generación (como Microsoft Sentinel, Splunk Enterprise Security, Elastic Security o IBM QRadar) incorporan además inteligencia de amenazas (Threat Intelligence), modelos de comportamiento de usuarios y entidades (UEBA), integración con lagos de datos (data lakes) y capacidades automatizadas. Sin embargo, estas características varían según el fabricante.
Definición operativa: Un SIEM convierte grandes cantidades de telemetría distribuida e inconexa en datos estructurados que un equipo de seguridad puede consultar, relacionar y utilizar para detectar e investigar actividad maliciosa.
2. La falacia de "guardar todos los logs": gestión de costes y valor #
Uno de los errores conceptuales más frecuentes en organizaciones que implementan su primer centro de operaciones es pensar:
«Tenemos 500 servidores y 4.000 puestos. Enviemos absolutamente todo lo que generen al SIEM.»
Técnicamente puede ser factible. Operativamente es una pésima decisión.
Cada evento ingerido genera costes directos e indirectos:
- Coste de transferencia de red e ingestión en plataformas SaaS o cloud.
- Coste de computación para parsear y normalizar el evento en memoria.
- Coste de almacenamiento en discos rápidos de alto rendimiento.
- Degradación en la velocidad de respuesta de las consultas analíticas del equipo.
- Incremento exponencial de falsos positivos y fatiga de alertas para los analistas.
No todos los logs aportan el mismo valor a una investigación. Comparemos dos fuentes reales:
| Fuente | Volumen típico | Valor investigativo | Tratamiento recomendado |
|---|---|---|---|
| Fuente A: Autenticaciones privilegiadas de administradores y cambios en Active Directory. | Bajo (cientos o miles al día). | Crítico. Esencial para detectar movimientos laterales, elevación de privilegios y persistencia. | Ingestión completa, almacenamiento analítico en caliente y reglas de detección en tiempo real. |
| Fuente B: Mensajes de diagnóstico de depuración (debug) de un clúster de balanceadores de carga. | Masivo (decenas de millones al día). | Muy bajo. Ruido repetitivo sin significado directo para ciberseguridad defensiva. | Filtrar en origen, descartar o desviar a almacenamiento frío/archivo económico. |
La pregunta fundamental que debe guiar el diseño nunca es «¿qué logs podemos enviar?», sino: «¿qué telemetría necesitamos para detectar, investigar y reconstruir los escenarios de compromiso que amenazan a la organización?».
3. Arquitectura del SIEM: el ciclo de vida de la telemetría #
Para entender qué ocurre detrás de los gráficos del panel de control, podemos modelar el funcionamiento interno de un SIEM en diez fases sucesivas:
│
INVESTIGACIÓN ◄── TRIAJE ◄── ALERTA ◄── DETECCIÓN / CORRELACIÓN ◄── BÚSQUEDA ◄─┘
Cada fabricante implementa estas etapas mediante tecnologías distintas, pero los principios analíticos que gobiernan la información son idénticos.
4. Fuentes de telemetría y priorización defensiva #
Un SIEM ingesta datos de decenas de capas tecnológicas diferentes. En lugar de conectar sistemas al azar, un SOC profesional prioriza según el valor forense:
- Capa de Identidad: Controladores de dominio Active Directory, Entra ID (Azure AD), Okta y proveedores IAM. Aportan inicios de sesión, cambios de credenciales, MFA y gestión de cuentas privilegiadas (Event IDs de Windows como 4624, 4625 o 4720).
- Capa de Endpoint: Agentes EDR y telemetría granular de Sysmon o Windows Event Logs. Permite conocer procesos creados, hashes SHA256, líneas de comandos, inyección de memoria y modificaciones de archivos.
- Capa de Red y Perímetro: Cortafuegos (Palo Alto, Fortinet, Check Point), concentradores VPN, servidores DNS corporativos, proxies web y sistemas IDS/IPS. Aportan direcciones IP origen/destino, resolución de dominios y puertos de conexión.
- Capa Cloud: Registros de gestión como AWS CloudTrail, Azure Activity Logs o Google Cloud Audit Logs. Permiten auditar creación de máquinas virtuales, apertura de cubos S3 o manipulación de políticas de acceso.
- Sistemas críticos y aplicaciones: Servidores de bases de datos, software ERP, pasarelas de pago y aplicaciones web empresariales.
Aplica siempre la regla de oro: «Si mañana comprometen este servidor crítico, ¿qué evidencia necesitaría tener registrada para saber con certeza cómo entraron y qué datos tocaron?».
5. Ingestión y salud de conectores #
Para trasladar los eventos desde el origen hasta el repositorio central se emplean diversos mecanismos de transporte:
- Agentes en host: Software ligero instalado en el endpoint (como Winlogbeat, Splunk Universal Forwarder o el agente de Azure Monitor) que lee eventos locales y los transmite de forma segura cifrada vía TLS.
- Syslog / CEF (Common Event Format): Protocolo estándar de red (UDP/TCP 514) ampliamente soportado por firewalls, switches y appliances de red que envían flujos directos hacia colectores del SIEM.
- APIs y Webhooks: Conectores que interrogan periódicamente interfaces REST de servicios SaaS (Office 365, Salesforce, GitHub) para extraer registros de auditoría.
- Windows Event Forwarding (WEF): Mecanismo nativo de suscripciones de Windows para centralizar eventos en servidores colectores antes de remitirlos al SIEM.
El problema silencioso: la telemetría ausente
Supongamos que tu equipo diseñó una regla de detección perfecta contra ataques de fuerza bruta en el Directorio Activo. El panel del SIEM no muestra alertas y la interfaz está en verde.
Sin embargo, hace seis horas el servicio del conector de Active Directory se detuvo por un problema de certificados. El SIEM sigue funcionando, pero está operando ciego.
Por eso, un SOC maduro monitoriza activamente la salud de su propia ingestión:
- ¿Cuándo se registró el último evento de cada fuente crítica?
- ¿Ha caído bruscamente el caudal medio de eventos por segundo (EPS)?
- ¿Se ha disparado el volumen de forma anómala (posible tormenta de logs o ataque DoS)?
6. Parsing vs. Normalización: estructurar y estandarizar #
Estos dos conceptos suelen confundirse con frecuencia entre principiantes, pero representan fases completamente distintas del procesamiento de datos.
A. Parsing (Extracción de campos)
Un cortafuegos emite un registro en texto plano no estructurado:
Oct 06 14:32:12 FW-CORP-01 ALLOW src=10.10.20.15 dst=203.0.113.50 dpt=443 proto=TCPEl parser aplica expresiones regulares o analizadores léxicos para desglosar esa cadena en variables individuales estructuradas:
timestamp        = 2026-10-06 14:32:12
device           = FW-CORP-01
action           = ALLOW
src              = 10.10.20.15
dst              = 203.0.113.50
dpt              = 443
proto            = TCP
B. Normalización (Esquema común universal)
Ahora consideremos que en la misma empresa conviven tres tecnologías diferentes que auditan la dirección IP de origen:
Firewall A (Fortinet)  → src=10.10.20.15
Firewall B (Palo Alto) → sourceAddress=10.10.20.15
Proxy web (Squid)      → client_ip=10.10.20.15
Si quisiéramos crear una regla para buscar la IP 10.10.20.15 sin normalización, tendríamos que escribir tres consultas independientes adaptadas a la nomenclatura de cada fabricante. La normalización mapea esos campos dispares a un modelo de información común unificado:
source.ip = 10.10.20.15Modelos como ASIM (Advanced Security Information Model) en Microsoft Sentinel o ECS (Elastic Common Schema) en Elastic permiten que una sola regla analítica interrogue la variable source.ip con independencia de la marca del dispositivo que originó el registro.
7. Almacenamiento, retención y tiers analíticos #
Almacenar terabytes de datos en discos de estado sólido ultrarrápidos durante años es económicamente insostenible para la mayoría de las organizaciones. Por ello, las plataformas SIEM implementan estrategias de almacenamiento por niveles (Tiers):
| Nivel de almacenamiento | Propósito principal | Rendimiento y coste | Tiempo de retención típico |
|---|---|---|---|
| Hot / Analytics Tier (Caliente) | Detección en tiempo real, alertas continuas, triaje inmediato e investigaciones del día a día. | Máxima velocidad de indexación y búsqueda. Mayor coste por gigabyte. | 30 a 90 días. |
| Cold / Archive Tier (Frío / Data Lake) | Threat Hunting histórico, reconstrucción pericial de incidentes pasados y cumplimiento de normativas legales. | Búsquedas más lentas (o asíncronas). Coste de almacenamiento drásticamente reducido. | 1 a 7 años (según regulación). |
El criterio para fijar el tiempo de retención depende de la normativa aplicable (como RGPD, PCI-DSS o NIS2) y del tiempo medio que tarda una empresa en descubrir que ha sido vulnerada (dwell time, que a menudo supera los 60 días).
8. Búsquedas y consultas: la destreza nuclear del analista #
Antes de automatizar flujos complejos o diseñar reglas analíticas, un analista SOC debe ser un experto buscando datos. La interfaz visual de un SIEM se apoya en lenguajes de consulta especializados:
- KQL (Kusto Query Language): Utilizado en Microsoft Sentinel y Azure Data Explorer. Destaca por su sintaxis basada en tuberías (
|) legibles y directas. - SPL (Search Processing Language): El lenguaje histórico de Splunk, con enorme potencia para transformaciones estadísticas y agregaciones.
- ES|QL / Lucene: Utilizados en el ecosistema Elastic Stack para búsquedas analíticas iterativas.
Sin embargo, la sintaxis técnica es secundaria. Lo prioritario es formular la pregunta de investigación adecuada:
// Ejemplo conceptual en KQL (Microsoft Sentinel):
// Identificar cuentas de usuario con más de 5 inicios de sesión fallidos en los últimos 30 minutos
SecurityEvent
| where TimeGenerated >= ago(30m)
| where EventID == 4625
| summarize Fallos = count() by TargetUserName, IpAddress
| where Fallos >= 5
| sort by Fallos desc
// Ejemplo conceptual en SPL (Splunk):
// Misma lógica expresada en Search Processing Language
index=security EventCode=4625 earliest=-30m
| stats count as Fallos by TargetUserName, IpAddress
| where Fallos >= 5
| sort - Fallos9. Reglas de detección: de la hipótesis a la alerta #
Una búsqueda se ejecuta cuando el analista la solicita de forma interactiva. Una regla de detección (Analytics Rule) es una consulta programada que el SIEM evalúa de manera automática contra el flujo de datos entrante cada determinado intervalo de tiempo.
Existen varias clases fundamentales de lógica analítica:
- Detecciones por umbral: Disparan cuando un contador supera un límite predefinido (ej. más de 20 fallos de login en 2 minutos). Fáciles de implementar, pero susceptibles a ser evadidas por atacantes lentos (low and slow).
- Detecciones por correspondencia con IoCs: Cruce continuo de hashes de archivos, IPs externas o dominios contra listas de Threat Intelligence actualizadas.
- Detecciones por secuencia causal: Evalúan un orden temporal estricto (ej. fallo de autenticación $\rightarrow$ éxito desde la misma IP $\rightarrow$ creación de proceso anómalo en menos de 5 minutos).
- Detecciones por línea base comportamental: Identifican desviaciones estadísticas respecto al histórico habitual de un usuario o activo (ej. inicio de sesión de un empleado desde un país en el que nunca antes había operado).
Para profundizar en el método analítico, diseño de hipótesis y crear buenas reglas de detección sin ahogar al SOC en ruido, la disciplina de Detection Engineering aporta el ciclo de vida indispensable. Asimismo, para escribir y compartir estas lógicas de manera neutral sin acoplarse a la sintaxis propietaria de un motor concreto, los equipos de ingeniería defensiva utilizan Sigma, traduciendo firmas YAML a las consultas nativas de cada SIEM mediante pipelines y backends especializados.
10. Correlación de eventos: uniendo piezas dispersas #
El verdadero valor diferencial del SIEM frente a revisar consolas independientes radica en la correlación entre fuentes heterogéneas. Para vincular eventos de distintos sistemas no basta con que hayan ocurrido a la misma hora; se necesita enlazar entidades compartidas:
| Entidad pivote | Ejemplo | Fuentes que conecta |
|---|---|---|
| Identidad / Usuario | mlopez / mlopez@empresa.com |
Active Directory (login) + VPN (túnel de acceso) + Correo (phishing recibido) + Proxy (navegación web). |
| Dirección IP | 198.51.100.30 (origen externo) |
Firewall (conexión perimetral) + Servidor web (solicitud HTTP) + NetFlow + VPN. |
| Nombre de host | WS-FINANZAS-07 |
Windows Event Logs + Sysmon + EDR + Antivirus corporativo + DHCP. |
| ProcessGuid / Hash | {BBB-222...} / SHA256=a8f5c... |
Sysmon Event 1 (proceso) + Sysmon Event 3 (conexión) + EDR + Sandboxing. |
11. De detección a incidente: agregación de alertas #
En plataformas profesionales, las alertas individuales rara vez se investigan de forma aislada. Los SIEM modernos incorporan motores de agregación que consolidan múltiples alertas relacionadas bajo un único Incidente de seguridad:
Esta consolidación reduce el ruido operacional y proporciona al analista una perspectiva integral del ataque en lugar de forzarle a cerrar tres tickets desconectados.
12. Qué hace un analista SOC dentro del SIEM en el día a día #
Lejos de observar paneles con mapas tridimensionales, la labor analítica en el centro de operaciones sigue un método estructurado en ocho pasos:
- Recepción y lectura de la alerta: Entender qué regla disparó el aviso, qué severidad tiene asignada y qué campos técnicos activaron la condición.
- Validación de la calidad del dato: Verificar que los campos se hayan parseado correctamente y que no existan errores de marca temporal (desfases UTC).
- Ampliación de la ventana temporal: Si la alerta saltó a las 14:10, examinar la actividad entre las 13:40 y las 14:40 para observar qué precedió al evento.
- Pivotaje analítico: Utilizar las entidades detectadas (usuario, IP, máquina) para lanzar consultas sobre otras tablas y fuentes.
- Cruce de telemetría complementaria: Consultar registros de proxy, DNS y endpoint asociados a esas entidades.
- Construcción de la cronología (Timeline): Reconstruir la secuencia ordenada de los hechos con marcas de tiempo normalizadas.
- Determinación del alcance (Blast Radius): Comprobar si otros activos de la red contactaron la misma IP maliciosa o si la cuenta comprometida autenticó en otros servidores.
- Documentación y reporte técnico: Redactar las conclusiones justificando con evidencia objetiva si se trata de un falso positivo o de un incidente confirmado.
13. Triage, falsos positivos y tuning de reglas #
El objetivo del triaje no es cerrar alertas lo más rápido posible. Tratar el centro de operaciones como una cadena de montaje donde prima la cantidad de tickets cerrados suele ocultar intrusiones reales bajo clasificaciones superficiales. Si quieres dominar el método de análisis forense preliminar, la reconstrucción cronológica y la clasificación rigurosa de veredictos, consulta nuestra guía paso a paso sobre triage de alertas SOC.
Falsos positivos: la señal sin contexto
Una regla que alerte ante cualquier uso de powershell.exe generará cientos de falsos positivos diarios, no porque la regla sea inútil, sino porque carece de contexto. Los administradores legítimos usan PowerShell todos los días.
Tuning (Ajuste fino de detecciones)
El tuning consiste en refinar la consulta analítica para aumentar su precisión sin perder capacidad de detección:
- Incorporar filtros por proceso padre (ej. PowerShell ejecutado por Word o Excel).
- Excluir cuentas de servicio conocidas que ejecutan tareas automatizadas en horarios fijos.
- Añadir listas blancas estrictas basadas en rutas completas y hashes firmados.
Advertencia técnica: Nunca hagas exclusiones amplias como
where User != "SYSTEM"owhere Image notstartswith "C:\Windows"para silenciar una regla. Reducirás el ruido a costa de generar enormes puntos ciegos aprovechables por los adversarios.
14. Delimitación: SIEM vs. EDR y SOAR #
En el mercado de las operaciones defensivas coexisten diversas tecnologías que conviene delimitar con claridad técnica (para una comparativa exhaustiva sobre visibilidad de endpoints e incidentes multivectoriales, consulta nuestra guía sobre EDR y XDR frente al antivirus):
| Tecnología | Alcance principal | Capacidad distintiva | Relación funcional |
|---|---|---|---|
| SIEM | Visión global transversal de toda la organización (identidad, red, servidores, cloud, aplicaciones). | Ingestión masiva, normalización, correlación multifuente y retención a largo plazo. | El SIEM agrega la telemetría del EDR junto con los logs de red y nube. |
| EDR | Profundidad forense en el endpoint (puestos de trabajo y servidores). | Inspección de kernel, memoria de procesos, bloqueo en tiempo real y aislamiento de host en red. | El EDR alimenta al SIEM con alertas y eventos detallados de host. |
| SOAR | Respuesta y automatización entre herramientas. | Playbooks automáticos, orquestación de APIs y reducción de tareas manuales repetitivas. | El SOAR recibe los incidentes calificados del SIEM y ejecuta acciones de contención. |
Para profundizar en cómo interactúa la orquestación con los playbooks de respuesta, revisa nuestro análisis completo sobre SIEM vs SOAR: diferencias y ejemplos.
15. Threat Hunting: investigación proactiva en el SIEM #
Mientras que la monitorización tradicional es reactiva (el analista espera a que el SIEM dispare una alerta), el Threat Hunting opera bajo la premisa inversa:
«Asumimos que un atacante puede haber evadido nuestras defensas perimetrales y está operando en la red sin haber disparado ninguna regla predefinida.»
El analista formula una hipótesis basada en tácticas y técnicas de MITRE ATT&CK y busca anomalías estadísticas en los datos fríos o calientes del SIEM. Por ejemplo:
Hipótesis: Algún atacante podría estar utilizando binarios legítimos de Windows (LOLBins) para descargar código.
Búsqueda: Certutil.exe ejecutado con argumentos de red (-urlcache, -split) en cualquier endpoint en los últimos 30 días.
Para aprender la metodología completa de formulación de hipótesis refutables, diseño de consultas progresivas por capas y pivote entre entidades en endpoints y redes, consulta nuestra guía sobre Threat Hunting desde cero.
16. Calidad del dato y contexto organizacional #
Un SIEM de última generación no puede suplir la mala calidad en los datos de entrada:
Principio fundamental: Basura entra, basura sale (Garbage In, Garbage Out). Si los servidores tienen sus relojes desincronizados, los firewalls truncan los campos o los parsers intercambian la IP de destino por la de origen, ninguna regla de correlación funcionará correctamente.
Asimismo, el SIEM no sabe qué es normal en tu empresa por arte de magia. Observar diez mil conexiones salientes a las dos de la madrugada puede parecer una intrusión masiva hasta que se comprueba que se trata de la ventana programada del servidor de copias de seguridad corporativo. El conocimiento del negocio y la criticidad de los activos son indispensables para emitir juicios certeros.
17. Caso práctico: investigación correlacionada paso a paso #
Examinemos un caso práctico real donde un analista SOC correlaciona telemetría multifuente a través del SIEM:
1. 10:21 — Identidad (Controlador de Dominio)
Se registran tres eventos consecutivos de inicio de sesión fallido (Event ID 4625) sobre la cuenta mlopez procedentes de la dirección IP externa 198.51.100.30.
2. 10:23 — Identidad (Autenticación correcta)
Dos minutos después se genera un evento de login correcto (Event ID 4624) para la misma cuenta mlopez desde la misma dirección IP 198.51.100.30.
3. 10:25 — Endpoint (Telemetría de Sysmon)
En el equipo asignado al usuario (WS-FINANZAS-07), Sysmon registra el Event ID 1: el proceso WINWORD.EXE inicia powershell.exe con argumentos codificados en base64.
4. 10:25 — Servidor DNS corporativo
El mismo equipo WS-FINANZAS-07 realiza una consulta DNS (Sysmon Event ID 22) solicitando la resolución del dominio no clasificado files-example.test.
5. 10:26 — Firewall perimetral
El cortafuegos corporativo registra tráfico saliente permitido (Action: ALLOW) desde WS-FINANZAS-07 hacia la dirección IP externa 203.0.113.40:443.
6. 10:27 — Sistema de ficheros (Sysmon)
Sysmon registra el Event ID 11: creación del archivo ejecutable update.exe en la ruta C:\Users\mlopez\AppData\Local\Temp\.
Conclusión analítica para el informe: «A las 10:23 se detectó acceso válido a la cuenta mlopez tras intentos fallidos desde 198.51.100.30. A las 10:25, en el equipo WS-FINANZAS-07, WINWORD.EXE ejecutó PowerShell, el cual consultó files-example.test, estableció conexión TCP/443 con 203.0.113.40 y depositó update.exe en AppData\Local\Temp. Se procede a aislar el endpoint, bloquear la IP en el firewall perimetral y restablecer credenciales del usuario».
18. Laboratorio práctico: 7 ejercicios desde cero #
No necesitas una infraestructura corporativa para entrenar tus habilidades de SIEM. Puedes montar una instancia comunitaria gratuita de Elastic Stack, Splunk Free o utilizar Microsoft Sentinel con créditos de aprendizaje:
Laboratorio 1: Ingesta y validación de campos
Configura el reenvío de logs de seguridad de una máquina Windows hacia tu SIEM mediante Winlogbeat o el agente correspondiente. Comprueba que los eventos lleguen, revisa qué campos están estructurados y valida la marca temporal UTC.
Laboratorio 2: Búsquedas básicas y agregaciones
Genera inicios de sesión correctos y fallidos. Escribe consultas para filtrar por usuario, calcular el recuento total de fallos y agrupar los resultados por dirección IP de origen.
Laboratorio 3: Ingesta de Sysmon y árboles de procesos
Instala Sysmon en el host. Ejecuta una cadena de procesos (CMD $\rightarrow$ PowerShell $\rightarrow$ Notepad). Localiza el Event ID 1 en el SIEM y reconstruye la jerarquía utilizando los campos ProcessGuid y ParentProcessGuid.
Laboratorio 4: Correlación de DNS y red
Genera tráfico web y consultas DNS hacia un dominio de prueba. Escribe una consulta en el SIEM que una el proceso local que inició la consulta con el socket TCP saliente registrado en los logs del cortafuegos.
Laboratorio 5: Creación de una regla de detección simple
Diseña una regla analítica programada que alerte ante más de tres intentos fallidos de autenticación (4625) seguidos de uno exitoso (4624) en una ventana de 5 minutos. Fuerza la condición para comprobar el disparo del aviso.
Laboratorio 6: Tuning y gestión de excepciones
Simula una tarea administrativa legítima que active tu regla de detección. Modifica la consulta para excluir ese caso específico sin utilizar comodines genéricos que generen puntos ciegos.
Laboratorio 7: Investigación forense de un incidente completo
Pide a un compañero que ejecute un escenario simulado (login $\rightarrow$ comando $\rightarrow$ red $\rightarrow$ archivo). Reconstruye minuciosamente la secuencia apoyándote exclusivamente en las búsquedas del SIEM y documenta el incidente.
19. Qué aprender antes del SIEM y competencias junior #
Uno de los errores más comunes al iniciarse en Blue Team es lanzarse directamente a memorizar consultas de Sentinel o Splunk sin dominar los fundamentos que alimentan la herramienta. El orden pedagógico riguroso debe ser:
Un analista SOC junior no necesita saber administrar la infraestructura interna de un SIEM corporativo complejo, pero sí debe dominar:
- Explicar con claridad qué problema resuelve un SIEM en el centro de operaciones.
- Identificar las fuentes principales de telemetría y su valor investigativo.
- Distinguir entre parsing y normalización de datos.
- Ejecutar búsquedas analíticas, filtrar por ventanas temporales y agrupar resultados.
- Pivotar con soltura entre entidades (usuario, dirección IP, equipo, proceso).
- Construir una cronología técnica coherente y documentar conclusiones respaldadas por evidencias.
Para profundizar en los requisitos y el perfil profesional, consulta nuestra guía sobre qué necesita saber un analista SOC o revisa la ruta integral para cómo convertirse en analista SOC.
20. Preguntas frecuentes sobre SIEM #
¿Qué es un SIEM? #
Un SIEM (Security Information and Event Management) es una plataforma tecnológica que centraliza, normaliza, almacena y analiza eventos de seguridad procedentes de múltiples sistemas para facilitar la detección de amenazas, la correlación de datos y la investigación de incidentes en el SOC.
¿Qué significan las siglas SIEM? #
Security Information and Event Management, traducido habitualmente al español como Gestión de Información y Eventos de Seguridad.
¿Para qué sirve un SIEM? #
Sirve para recopilar telemetría de toda la organización, ejecutar búsquedas analíticas rápidas, activar reglas automáticas de detección de intrusiones, correlacionar eventos entre fuentes distintas y conservar evidencias para investigaciones forenses.
¿Qué datos recibe un SIEM? #
Eventos de autenticación de Active Directory/Entra ID, registros de procesos de endpoints (Sysmon/EDR), tráfico de firewalls y proxies, consultas DNS, registros de auditoría cloud (AWS, Azure, GCP) y logs de aplicaciones corporativas.
¿Un SIEM es un antivirus? #
No. Un antivirus o EDR se ejecuta localmente en el endpoint para inspeccionar ficheros y bloquear amenazas en el equipo. El SIEM opera a nivel central agregando información de cientos o miles de dispositivos simultáneamente.
¿SIEM y SOAR son lo mismo? #
No. El SIEM se especializa en la ingestión, búsqueda, correlación y detección de alertas. El SOAR se enfoca en la orquestación, automatización de flujos y ejecución de playbooks de respuesta. Actualmente muchas plataformas combinan ambas funciones.
¿SIEM y EDR son lo mismo? #
No. El EDR ofrece gran profundidad en los procesos y memoria de los puestos de trabajo. El SIEM ofrece una perspectiva horizontal conectando la actividad del endpoint con eventos de identidad, perímetro de red y servicios en la nube.
¿Tengo que aprender Splunk, Microsoft Sentinel o Elastic? #
Cualquiera de ellas es válida para adquirir destrezas prácticas. Los principios fundamentales (parsing, normalización, correlación, formulación de consultas lógicas y cronología forense) se transfieren de manera inmediata entre plataformas.
¿Qué lenguaje utiliza un SIEM? #
Depende del fabricante: Microsoft Sentinel utiliza KQL (Kusto Query Language), Splunk utiliza SPL (Search Processing Language) y Elastic emplea ES|QL o sintaxis Lucene. Lo primordial es saber qué pregunta lógica deseas formular a los datos.
¿Un SIEM detecta ataques automáticamente? #
El SIEM evalúa reglas de detección programadas y emite alertas cuando se cumplen determinadas condiciones. Sin embargo, una alerta no es un incidente confirmado: requiere que un analista humano valide el contexto y descarte falsos positivos.
¿Hay que enviar todos los logs corporativos al SIEM? #
No. Ingerir datos sin valor investigativo encarece los costes de almacenamiento y ralentiza las búsquedas. Debe priorizarse la telemetría que responda a casos de uso concretos de detección, triaje y cumplimiento normativo.
21. Conclusión y fuentes oficiales #
Un SIEM comienza siendo un repositorio donde convergen grandes volúmenes de datos dispersos. Sin embargo, su valor no reside en acumular gigabytes de información en discos duros, sino en su capacidad para transformar millones de eventos en una pregunta analítica precisa, una búsqueda estructurada, una secuencia causal clara y, finalmente, una conclusión pericial respaldada por evidencias objetivas.
Cuando te enfrentes a una alerta en la consola de un centro de operaciones, no preguntes únicamente qué dice el panel visual. Pregúntate: «¿Qué telemetría utilizó el SIEM para llegar a esta deducción y qué hechos puedo demostrar con ella?». Esa distinción separa a quien simplemente opera una herramienta de quien investiga como un auténtico profesional de ciberseguridad.
Para continuar estructurando tu progresión defensiva, consulta el Blue Team roadmap o consolida tus bases con nuestra guía sobre logs de seguridad.
Fuentes oficiales y documentación técnica revisada #
- Microsoft Learn: What is Microsoft Sentinel? (Visión general de arquitectura SIEM moderna en cloud).
- Microsoft Learn: Advanced Security Information Model (ASIM) (Especificación técnica de normalización de datos y esquemas comunes).
- IBM Documentation: What is SIEM? (Evolución conceptual e integración histórica de SIM y SEM).
- Splunk Documentation: Search Processing Language (SPL) Fundamentals.
- Elastic Documentation: Elastic Common Schema (ECS) Reference (Estándar de normalización de campos para telemetría).
Última revisión técnica: 07 de octubre de 2026.