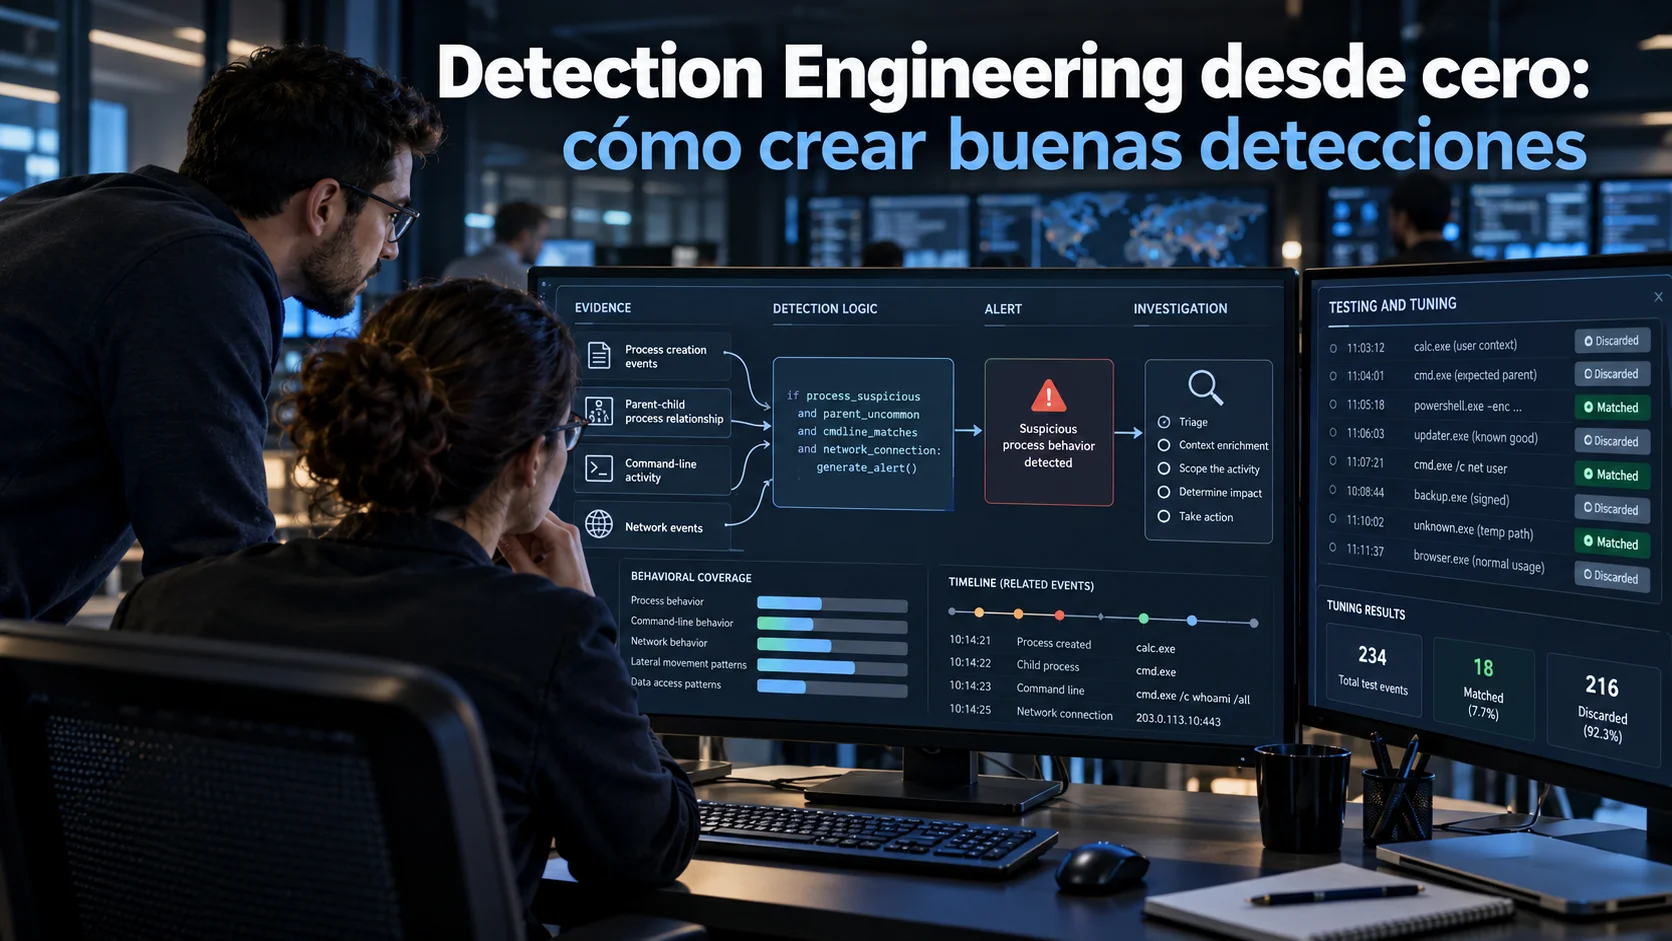
Respuesta rápida: ¿Qué es Detection Engineering en ciberseguridad?
Detection Engineering (ingeniería de detección) es la disciplina técnica y metodológica encargada de diseñar, construir, validar, desplegar y mantener mecanismos de detección sobre flujos de logs de seguridad y telemetría de sistemas. A diferencia de simplemente redactar consultas sueltas en una consola, Detection Engineering trata cada regla como un producto de software operativo: parte de una amenaza y un comportamiento técnico específico, verifica la existencia de evidencia objetiva en los sensores, formula una hipótesis comprobable, realiza pruebas positivas y negativas, añade contexto de investigación y se ajusta continuamente mediante el feedback del triage de alertas SOC.
El problema: la consulta funciona, la detección no #
Quieres detectar actividad sospechosa relacionada con PowerShell en los puestos de trabajo corporativos.
Abres la consola de tu SIEM y escribes:
process.name = "powershell.exe"Ejecutas la sentencia. Funciona.
De hecho, funciona demasiado bien.
Cinco minutos después tienes cientos de coincidencias parpadeando en la pantalla:
- Administradores gestionando servidores remotos.
- Scripts corporativos de despliegue de parches.
- Herramientas de soporte técnico resolviendo incidencias de usuarios.
- Automatizaciones programadas del sistema operativo.
- Procesos legítimos de herramientas ofimáticas y software de respaldo.
Y quizá, perdido en medio de ese océano ensordecedor de eventos normales, se encuentra el comando exacto que un adversario utilizó para descargar un payload en memoria.
La consulta técnica funciona.
La consulta funciona. La detección no.
Ésa es la mejor manera de entender qué problema viene a resolver Detection Engineering.
No consiste en conseguir que una consulta sintáctica devuelva filas de una base de datos. Consiste en diseñar señales analíticas de alta fidelidad que permitan discriminar con precisión quirúrgica la actividad adversaria relevante dentro del inmenso volumen de ruido operativo diario.
Qué es Detection Engineering: un producto operativo #
Detection Engineering es la disciplina que diseña, implementa, valida, despliega y mantiene mecanismos destinados a identificar comportamientos de seguridad relevantes dentro de la telemetría disponible.
Una detección moderna rara vez consiste en buscar una cadena de texto aislada. Puede articularse mediante:
- Eventos individuales atómicos: Creación de servicios con privilegios anómalos o llamadas a APIs críticas.
- Relaciones jerárquicas entre procesos: Árboles de linaje padre-hijo (Parent-Child process relationships).
- Secuencias temporales causales: Autenticación fallida seguida de acceso exitoso y posterior ejecución de scripts.
- Umbrales y agregaciones: Múltiples conexiones salientes hacia destinos no categorizados en ventanas de tiempo breves.
- Líneas base estadísticas y rareza: Binarios ejecutados por primera vez en un clúster de máquinas o comandos poco habituales.
- Correlación multifuente: Cruce simultáneo de eventos de identidad, correo electrónico y Sysmon en endpoints.
Y la detección final puede terminar materializada en diversos formatos según la arquitectura corporativa: una regla analítica en Splunk (SPL), una detección personalizada en Microsoft Sentinel o Defender (KQL), una regla de correlación en Elastic Security (EQL/KQL) o una firma estandarizada en formato reglas Sigma.
Pero el código de la query es únicamente la punta del iceberg.
Tanto Elastic como Microsoft definen actualmente los programas maduros de detección como ciclos continuos de ingeniería: análisis de disponibilidad de datos, validación previa en laboratorio, asignación de entidades, guías de investigación, supervisión de rendimiento y calibración continua de excepciones.
Una detección es un producto operativo, no sólo una consulta.
Detection Engineering empieza antes del SIEM #
Supongamos que el equipo de seguridad recibe una directiva vaga:
“Necesitamos detectar PowerShell sospechoso en la empresa.”
En ese momento todavía no tenemos una detección. Tenemos únicamente una intención abstracta y difusa.
El ingeniero de detección inicia el trabajo formulando una pregunta mucho más granular:
¿Qué comportamiento técnico concreto me preocupa y qué amenaza representa?
Por ejemplo:
Microsoft Office (WINWORD.EXE / EXCEL.EXE)
       ↓
Inicia PowerShell
       ↓
Recibe una línea de comandos con argumentos de ofuscación (-enc, -w hidden)
Ahora tenemos un escenario técnico claramente delimitado. La siguiente pregunta obligatoria es:
¿Qué evidencia observable en el sistema debería producir ese comportamiento?
Identificamos los atributos mínimos que deben quedar registrados:
process.name(el ejecutable secundario:powershell.exe)process.parent.name(el ejecutable progenitor:WINWORD.EXE)process.command_line(los parámetros completos de invocación)user.name(la cuenta de usuario que lanzó la aplicación)host.name(la estación de trabajo o servidor implicado)timestamp(la marca temporal exacta del evento)
Y finalmente planteamos la pregunta más crítica de todas:
¿Tenemos realmente esa telemetría recolectada e indexada con esa riqueza de campos en nuestra plataforma?
Si la respuesta es negativa, escribir una consulta en el SIEM carece de sentido. Primero debe resolverse la visibilidad técnica en los endpoints.
La cadena completa de una detección #
Para no perderse en la complejidad de herramientas y sintaxis, resulta esencial visualizar la ingeniería de detección como una cadena secuencial de siete eslabones:
Si cualquiera de estos eslabones se rompe, toda la inversión defensiva situada aguas abajo pierde su eficacia.
Considera este ejemplo de fallo habitual: una organización desea detectar la creación anómala de procesos en servidores Windows, pero en su repositorio centralizado sólo recopila registros de firewall perimetral y eventos de autenticación de Active Directory.
Ese problema no se soluciona inventando una consulta KQL de cincuenta líneas ni aplicando algoritmos de Machine Learning.
El problema es que falta evidencia técnica en el origen.
Paso 1. Define el comportamiento antes de escribir la regla #
Todo esfuerzo de ingeniería debe comenzar redactando una hipótesis técnica mediante una frase afirmativa y comprobable.
Compara estas tres formulaciones:
- Deficiente: “Detectar hackers utilizando PowerShell en la red.” (Demasiado subjetivo; el sistema no comprende qué es un hacker).
- Aceptable: “Detectar procesos de Microsoft Office que inicien instancias de PowerShell.” (Identifica ejecutables concretos y una relación observable).
- Excelente: “Detectar aplicaciones ofimáticas de Microsoft Office iniciando intérpretes de PowerShell con argumentos de línea de comandos infrecuentes en estaciones de trabajo de usuarios estándar.”
En este último nivel, la detección se construye sobre una relación empírica indiscutible:
parent_process = WINWORD.EXE
child_process = powershell.exe
La regla se sustenta sobre un hecho técnico visible en el sistema operativo, no sobre una conjetura sobre las intenciones del operador.
Detecta evidencia, no intenciones #
Los sistemas de monitorización y los registros de auditoría no tienen conciencia de los propósitos estratégicos de un ciberatacante.
El sensor del endpoint nunca ve en sus tablas:
“El atacante está intentando conseguir persistencia tras una intrusión.”
Lo que el sensor ve y escribe en el registro de Windows Event Logs o en Sysmon son hechos atómicos:
- Se creó una tarea programada mediante
schtasks.exe. - Se modificó el valor de una clave del registro en
CurrentVersion\Run. - Un proceso con privilegios estándar invocó a un proceso con nivel de integridad superior.
- Se autenticó una cuenta de usuario mediante Kerberos desde una subred no habitual.
- Se abrió un socket de red TCP hacia una dirección IP externa por un proceso no firmado.
Detecta evidencia, no intenciones.
La labor del Detection Engineer consiste en traducir comportamientos y técnicas adversarias en huellas observables e inequívocas. Éste es el motivo por el cual dominar los fundamentos de logs, eventos de Windows, telemetría de Sysmon y la matriz de MITRE ATT&CK para analistas SOC resulta indispensable antes de diseñar reglas: nadie puede modelar detecciones precisas sobre datos cuya estructura desconoce.
Paso 2. Define qué amenaza o caso de uso estás cubriendo #
Las reglas de detección no deben crearse al azar para acumular cientos de ficheros en un repositorio. Cada regla debe responder a una necesidad de protección justificada.
Las fuentes más habituales que originan nuevas detecciones son:
| Origen de la necesidad | Aporte a Detection Engineering | Ejemplo real |
|---|---|---|
| Incidentes previos (IR) | Vectores y artefactos aprovechados en brechas sufridas por la empresa. | Persistencia mediante DLL Search Order Hijacking observada en un incidente. |
| Investigaciones del SOC | Patrones descubiertos durante el análisis rutinario de actividad sospechosa. | Cuentas de servicio ejecutando comandos interactivos en consolas. |
| Threat Hunting | Comportamientos anómalos identificados de forma proactiva sin alerta previa. | Uso inusual de herramientas LoLBins (Living off the Land Binaries) como certutil.exe. |
| Threat Intelligence (CTI) | Procedimientos técnicos reportados en campañas activas dirigidas a tu sector. | Técnicas de exfiltración empleadas por actores de ransomware emergentes. |
| Ejercicios Red Team | Técnicas de evasión emuladas contra la infraestructura propia. | Caminos de ataque que eludieron las soluciones de EDR durante un ejercicio defensivo. |
Supongamos que un ejercicio de análisis forense reveló la siguiente secuencia:
WINWORD.EXE
     ↓
powershell.exe
     ↓
Descarga de ejecutable desde IP externa
El equipo define formalmente el caso de uso defensivo:
“Monitorizar aplicaciones ofimáticas invocando intérpretes de comandos en estaciones de trabajo para cortar la cadena de ejecución en etapas tempranas.”
Paso 3. Comprueba que existe la telemetría #
Antes de escribir la primera línea de código de una consulta en tu SIEM, debes someter la infraestructura a una auditoría de visibilidad empírica:
- ¿Disponemos del canal de eventos adecuado (Sysmon Event ID 1 o Windows Security 4688 con auditoría de línea de comandos activada por GPO)?
- ¿Están todos los puestos de trabajo corporativos enviando estos eventos o sólo un subconjunto de servidores?
- ¿Los nombres de los procesos padre e hijo están normalizados bajo un esquema común (CIM en Splunk o ECS en Elastic)?
- ¿Cuál es el retraso medio de ingestión desde que el proceso se ejecuta hasta que la base de datos indexa el registro?
- ¿Disponemos de suficiente retención de datos en caliente para realizar búsquedas retrospectivas?
Evolución crítica en MITRE ATT&CK (v18 y v19)
En versiones anteriores, ATT&CK categorizaba las fuentes mediante Data Sources genéricos y monolíticos. Desde ATT&CK v18, los antiguos Data Sources quedaron formalmente deprecados como estructura activa, evolucionando hacia un marco de tres niveles: Detection Strategies (enfoques conceptuales), Analytics (lógicas analíticas verificables) y Data Components (propiedades observables de los datos). ATT&CK v19 profundiza en este enfoque. Para un ingeniero de detección, la lección es rotunda: antes de preguntar qué regla redactar, define con precisión qué evidencia y qué Data Components necesitas recolectar.
Paso 4. Formula una hipótesis de detección refutable #
Una hipótesis de ingeniería debe plantearse en términos de probabilidad operativa, no de certeza matemática absoluta:
“En estaciones de trabajo de usuarios finales, el inicio de PowerShell por parte de procesos de Office es una actividad suficientemente infrecuente como para justificar una alerta investigable en el SOC, especialmente si concurren parámetros asociados a ejecución oculta u ofuscada.”
Observa que la hipótesis no afirma: “Si Word inicia PowerShell, la máquina está comprometida por malware”.
Afirmar eso confundiría una señal de detección con una conclusión de investigación. La regla debe alertar sobre una anomalía de alta relevancia que requiere atención; el analista humano o el playbook automatizado determinarán el veredicto definitivo.
Paso 5. Empieza por una lógica simple #
Uno de los errores más destructivos consiste en redactar desde el primer borrador una consulta gigantesca con decenas de filtros y condiciones concatenadas. Si la regla falla o genera un volumen anómalo, será imposible saber qué filtro causó el problema.
Comienza formulando la relación conceptual básica:
parent_process IN (
    "WINWORD.EXE",
    "EXCEL.EXE",
    "POWERPNT.EXE",
    "OUTLOOK.EXE"
)
AND child_process IN (
    "powershell.exe",
    "pwsh.exe"
)
Ejecuta esta consulta elemental sobre un rango representativo de datos históricos de tu organización (por ejemplo, los últimos 14 o 30 días). Analiza los resultados:
- ¿Cuántos eventos devuelve en total?
- ¿Qué departamentos o perfiles de usuario los concentran?
- ¿Qué líneas de comandos exactas se están ejecutando?
Quizá el análisis histórico revele que el 85 % de los disparos proceden de un complemento financiero legítimo que genera informes en Excel cada mañana. Ahora tienes datos empíricos para tomar decisiones de ingeniería en lugar de adivinar.
Paso 6. Analiza los falsos positivos antes de excluirlos #
Cuando una regla devuelve actividad legítima durante las pruebas, la reacción inmediata del analista inexperto suele ser insertar apresuradamente una cláusula NOT en la consulta.
El ingeniero de detección reflexiona antes de excluir:
- ¿Por qué se produce esa ejecución? ¿Es un script aprobado por la dirección de TI?
- ¿Qué usuario lo ejecuta y en qué equipos específicos?
- ¿Qué parámetros de línea de comandos utiliza?
- ¿Podría un atacante colocar un binario malicioso en la misma ruta para evadir la detección?
| Mecanismo de ajuste | Definición técnica | Criterio de aplicación |
|---|---|---|
| Tuning (Calibración) | Modificación de la lógica interna de la regla porque la definición original era demasiado permisiva o imprecisa. | Exigir parámetros de línea de comandos específicos o restringir a tipos de usuario concretos. |
| Exception (Excepción) | Mecanismo que conserva intacta la lógica analítica de la regla pero excluye una entidad conocida, autorizada y delimitada del entorno. | Excluir un script corporativo firmado ejecutado únicamente por una cuenta de servicio en el servidor de compilación. |
Tanto Elastic Security como Microsoft Defender XDR separan formalmente las excepciones del código de la regla: las excepciones actúan como capas desacopladas, lo que permite mantener la regla base limpia y auditar de forma independiente cada caso legítimo autorizado.
Una excepción demasiado amplia puede destruir una buena detección #
Imagina que para silenciar alertas provocadas por el personal de soporte técnico añades la siguiente exclusión a tu regla de detección:
NOT user.name = "admin_ti"¿Qué ocurre si un adversario compromete precisamente las credenciales de esa cuenta administrativa mediante un ataque de spray de contraseñas o phishing?
Habrás construido un punto ciego deliberado en tu infraestructura. El atacante podrá invocar PowerShell desde Word y tu sistema permanecerá en silencio.
Silencio no significa calidad.
Una regla que nunca alerta puede ser excelente. O puede estar rota.
Las excepciones deben acotarse siempre con el principio de mínimo privilegio analítico: combinar usuario específico, host concreto, ruta canónica inmutable y, de ser posible, hash o firma digital del script autorizado.
Paso 7. Decide qué tipo de lógica necesitas #
En función de la naturaleza del comportamiento analizado, la ingeniería de detección recurre a diversos patrones arquitectónicos de consulta:
| Patrón analítico | Mecánica de evaluación | Ejemplo de aplicación |
|---|---|---|
| Coincidencia simple (Simple match) | Filtro booleano sobre un campo en un evento individual. | Ejecución de vssadmin.exe delete shadows. |
| Relación entre campos (Field relationship) | Cruce de atributos jerárquicos en el mismo registro. | ParentImage = WINWORD.EXE e Image = powershell.exe. |
| Secuencia causal (Sequence) | Orden cronológico estricto entre eventos independientes dentro de una ventana de tiempo. | Apertura de adjunto en correo $\rightarrow$ creación de proceso $\rightarrow$ conexión externa saliente en menos de 120 segundos. |
| Umbral (Threshold / Aggregation) | Conteo de eventos agrupados por entidad que superan un límite numérico justificado. | Más de 25 intentos fallidos de autenticación en 5 minutos para una misma cuenta. |
| Rareza (New terms / Anomaly) | Identificación de valores que no figuran en la línea base histórica del activo. | Binario o servicio observado por primera vez en un servidor de producción. |
| Correlación multifuente (Cross-source) | Cruce de eventos de plataformas y tecnologías heterogéneas. | Alerta de viaje imposible en el proveedor Cloud combinada con creación de persistencia en el endpoint local. |
Paso 8. Decide qué contexto necesita la alerta #
Una alerta que llega a la cola del SOC con el título genérico “Comportamiento sospechoso detectado” y sin campos proyectados obliga al analista L1 a perder valiosos minutos abriendo consolas externas para reconstruir qué ocurrió.
Una detección bien diseñada proyecta directamente en el incidente las entidades críticas para el triaje:
- Entidades principales: Host implicado, cuenta de usuario, dirección IP, procesos padre e hijo.
- Evidencia técnica: Línea de comandos completa (
CommandLine), hash SHA256 del ejecutable y ruta de disco. - Guía de investigación (Investigation Guide): Instrucciones claras redactadas por el Detection Engineer indicando qué preguntas debe responder el analista (por ejemplo: “1. Revisar si el usuario abrió un correo con adjunto macro antes del evento; 2. Comprobar conexiones de red generadas por PowerShell en los siguientes 5 minutos; 3. Verificar si el script ejecutó comandos codificados”).
Una buena detección no se limita a responder qué condición técnica coincidió; orienta con precisión al analista hacia el siguiente paso de la investigación.
Paso 9. Prueba la regla antes de ponerla en producción #
Ningún ingeniero de software despliega código en producción sin pruebas unitarias e integración continua. En ciberseguridad defensiva se aplica la misma disciplina rigurosa.
Metodología de validación dual
- 01Prueba positiva: Emula de forma controlada el comportamiento que la regla pretende detectar (por ejemplo, invocando un script de PowerShell desde una macro benigna en un laboratorio aislado). ¿Se disparó la alerta esperada con todos sus campos?
- 02Prueba negativa: Ejecuta comportamientos superficialmente similares pero legítimos (por ejemplo, abrir una consola de PowerShell de forma interactiva desde el explorador de Windows o mediante un script de mantenimiento aprobado). ¿Permanece la regla en silencio sin disparar falsas alarmas?
Recuerda un principio básico de aseguramiento de calidad:
Una detección que funciona una sola vez todavía no está validada.
Debes probar variaciones en mayúsculas y minúsculas (los nombres de binarios en Windows son case-insensitive), rutas relativas frente a rutas absolutas, diferentes versiones del sistema operativo y evaluar qué ocurre cuando el evento llega con retraso por latencia en el agente de transporte.
Paso 10. Decide cuándo debe ejecutarse: frecuencia, ventana y lookback #
Una consulta analítica en un SIEM o plataforma de seguridad no se ejecuta de forma continua en tiempo real absoluto; corre de manera periódica según una programación definida por el Detection Engineer. Para que una detección funcione de forma fiable, debe existir una sincronía perfecta entre dos variables fundamentales:
Frecuencia de ejecución (Interval) vs. Ventana de búsqueda (Search Window / Lookback)A primera vista, la configuración más intuitiva parece ser una relación idéntica de 1 a 1:
- Frecuencia: ejecutar la regla cada 5 minutos.
- Ventana temporal: consultar los eventos generados en los últimos 5 minutos.
Sobre el papel parece impecable. Pero en las infraestructuras de producción reales existe un factor determinante: la latencia de transporte e ingesta de logs (ingestion lag).
El riesgo de la pérdida silenciosa de eventos
Si un endpoint corporativo pierde conectividad temporal durante 3 minutos, o el agente recolector encola eventos debido a picos de CPU, un evento generado a las 10:00 puede terminar indexándose en el repositorio a las 10:06. Si tu regla se ejecutó a las 10:05 analizando la ventana estricta de 10:00 a 10:05, y la siguiente ejecución a las 10:10 solo examina de 10:05 a 10:10, el evento de las 10:00 jamás será evaluado por la regla. Ha quedado en un punto ciego temporal permanente.
Para mitigar este problema operacional, las plataformas analíticas incorporan mecanismos de resiliencia temporal:
- Lookback adicional (Additional Look-back): La consulta retrocede deliberadamente más tiempo del intervalo de ejecución (por ejemplo, corre cada 5 minutos pero analiza los últimos 15 o 30 minutos). Esto garantiza capturar eventos rezagados que llegaron tarde al pipeline de ingesta.
- Ventanas superpuestas (Overlapping Windows): Permiten reexaminar los márgenes temporales para absorber fluctuaciones de red sin dejar huecos en la cronología.
- Deduplicación de alertas: Al ampliar la ventana temporal, un mismo evento podría coincidir en dos ejecuciones consecutivas. La plataforma debe deduplicar basándose en el identificador único del evento (o del host y proceso) para no generar tickets redundantes.
Microsoft Defender XDR documenta frecuencias programadas (desde cada hora hasta cada 24 horas o modo continuo según el tipo de regla) y advierte específicamente que el desfase entre la marca de tiempo de creación del evento y la marca de tiempo de ingestión debe tenerse en cuenta al definir la ventana de consulta. Por su parte, Elastic Security desglosa de manera nativa en sus reglas el Run every (interval), el Additional look-back time y el búfer de seguridad para absorber la latencia de transporte.
Más allá de la sintaxis particular de cada tecnología, la pregunta obligatoria que debes responder es:
¿Mi regla puede ver todos los eventos que necesita en el momento en que se ejecuta, incluso si la red sufre demoras de transporte?
Paso 11. Define severidad sin confundirla con certeza #
Cuando un Detection Engineer finaliza la lógica técnica de una regla, se enfrenta a la categorización de la alerta resultante. Un error habitual en equipos poco maduros consiste en etiquetar automáticamente como Critical o High cualquier comportamiento que involucre binarios potentes como PowerShell, Mimikatz o WMI.
Si la regla Microsoft Word inicia PowerShell se dispara en el entorno:
¿Debe clasificarse siempre con severidad crítica?
La respuesta técnica es: no necesariamente. Para clasificar con rigor profesional es imprescindible desacoplar dos dimensiones que suelen confundirse:
| Dimensión | Definición en Detection Engineering | Pregunta operativa que responde |
|---|---|---|
| Severidad (Severity) | El impacto potencial en el negocio si la actividad observada resulta ser efectivamente maliciosa (compromiso de credenciales de dominio, ejecución de ransomware, exfiltración de propiedad intelectual). | ¿Cuánto daño puede causar esta acción si es un atacante real? |
| Confianza / Fidelidad (Confidence) | La probabilidad estadística de que la señal represente una agresión ilegítima frente a la probabilidad de que corresponda a actividad administrativa benigna. | ¿Qué tan seguros estamos de que esto no es un falso positivo corporativo? |
Esta distinción genera combinaciones operativas fundamentales para el triaje:
- Severidad Alta + Confianza Media: La ejecución de PowerShell desde Word representa un riesgo grave si es un exploit de documento malicioso, pero una macro administrativa interna podría dispararlo legítimamente. El analista debe revisar el caso con prontitud, pero sin asumir ciegamente un incidente confirmado.
- Severidad Media + Confianza Alta: La detección de un script de reconocimiento como
whoami.exe /allonet userejecutado por una cuenta de servicio secundaria no compromete el dominio de inmediato (bajo impacto directo), pero la probabilidad de que alguien esté sondeando la máquina es muy alta.
Nunca conviertas la etiqueta Critical en sinónimo de “ataque comprobado e incontrovertible”. Como establecimos en la guía de triage de alertas SOC:
Una alerta no es una conclusión; es el punto de partida estructurado de una investigación.
Paso 12. Documenta la detección como un artefacto de ingeniería #
Una regla que solo vive en la cabeza del analista que la creó se convierte instantáneamente en deuda técnica para el SOC. En el momento en que esa persona cambia de equipo o abandona la organización, nadie se atreve a modificarla ni a retirarla por miedo a generar puntos ciegos o provocar incidentes operacionales.
Un estándar riguroso de Detection Engineering exige documentar formalmente cada regla mediante una ficha técnica estandarizada que cubra 13 campos indispensables:
Ficha técnica estándar de Detection Engineering (13 campos)
- 01Nombre (Name): Identificador descriptivo y normalizado (ej. Suspicious Child Process Spawned by Microsoft Word).
- 02Objetivo (Goal): Qué comportamiento adversarial intenta observar y qué técnica intenta mitigar.
- 03Hipótesis (Hypothesis): Fundamentación analítica de por qué este comportamiento representa una desviación de la normalidad.
- 04Telemetría requerida (Telemetry Sources): Sensores, proveedores de log y tablas indispensables (ej. Sysmon EID 1, Defender DeviceProcessEvents).
- 05Campos indispensables (Required Schema Fields): Atributos específicos que deben existir en el evento (
process.name,parent.process.name,process.command_line). - 06Lógica analítica (Logic): Condiciones de coincidencia, operadores y relaciones de campos.
- 07Mapeo MITRE ATT&CK: Tácticas, técnicas y sub-técnicas asociadas (ej. T1204.002, T1059.001).
- 08Falsos positivos conocidos (Known False Positives): Procesos legítimos, scripts de contabilidad o herramientas corporativas que coinciden habitualmente.
- 09Guía de investigación (Investigation Guide / Runbook): Pasos detallados para el analista L1/L2 indicando qué validar en los primeros 10 minutos.
- 10Severidad y Confianza: Puntuación asignada de impacto y fidelidad técnica con su debida justificación.
- 11Autor y Mantenedor: Ingeniero responsable de la detección y equipo de contacto.
- 12Versión (Version): Control semántico de versiones (ej.
v1.2.0) para auditar modificaciones de sintaxis. - 13Fecha de última validación: Registro de cuándo fue probada positivamente por última vez en laboratorio o producción.
Aplica este ejercicio de claridad en tu flujo diario:
Una regla debería poder explicarse con total claridad sin enseñar la query.
Si un responsable del SOC o un auditor pregunta qué hace una regla y la única respuesta posible es mostrar un bloque crudo de 50 líneas de KQL o SPL indescifrables, la ingeniería de detección ha fracasado. El ingeniero debe ser capaz de explicar:
“Esta regla detecta aplicaciones ofimáticas que engendran intérpretes de comandos en puestos de usuario. Se creó para identificar explotación de macros maliciosas y vectores iniciales por correo. Requiere telemetría de creación de procesos con linaje padre-hijo. Los únicos dos falsos positivos identificados corresponden a dos macros de facturación aprobadas, las cuales están acotadas por ruta y hash. Cualquier otra coincidencia requiere triaje prioritario.”
Después se analiza el código de la consulta. Nunca antes.
Paso 13. Despliega gradualmente y evalúa acciones de respuesta #
Publicar una regla directamente en la cola de producción del SOC sin un periodo de aclimatación es una práctica de alto riesgo. En ingeniería de software existe el concepto de canary deployment; en Detection Engineering aplicamos un ciclo de promoción gradual:
Una detección imperfecta no sólo genera fatiga por alertas; puede romper la continuidad operativa del negocio si produce:
- Miles de alertas en pocos minutos que colapsan el sistema de ticketing.
- Consumo masivo de cuota de computación o bloqueo de hilos en el clúster del SIEM.
- Activación descontrolada de acciones de remediación automática.
Plataformas como Microsoft Defender XDR permiten asociar detecciones personalizadas (Custom Detections) con acciones automáticas de respuesta, tales como aislar el dispositivo de la red (Isolate device), poner en cuarentena un archivo, forzar el restablecimiento de contraseñas de un usuario de Active Directory o purgar mensajes de correo. Si despliegas una regla con exclusiones insuficientes y acción de aislamiento automático, un script legítimo de despliegue de nóminas podría provocar el aislamiento instantáneo de cientos de servidores corporativos.
Cualquier regla vinculada a una acción automática de respuesta exige un nivel de validación empírica exponencialmente mayor.
Paso 14. Mide la salud continua de la detección #
Una regla de detección no es un monumento inmutable de piedra que se construye y se olvida. Es un componente dinámico de software que opera sobre un ecosistema en constante transformación. Una detección desplegada hace seis meses puede dejar de funcionar hoy sin emitir ningún aviso visible.
Para garantizar la integridad del catálogo defensivo, el equipo debe auditar periódicamente las métricas de salud técnica de cada regla:
Checklist de Salud Operativa:
[ ] ¿La regla se ejecuta dentro de su intervalo sin errores de sintaxis o timeout?
[ ] ¿Las fuentes de datos subyacentes continúan enviando eventos con normalidad?
[ ] ¿El esquema de logs ha modificado los nombres de los campos de consulta?
[ ] ¿Cuántas alertas ha generado en los últimos 30 días?
[ ] ¿Cuál es la proporción entre verdaderos positivos (TP) y falsos positivos (FP)?
[ ] ¿Las excepciones configuradas siguen teniendo vigencia o el software ya fue desmantelado?
[ ] ¿El comportamiento adversarial que modela sigue siendo relevante para la organización?
Tanto Elastic Security como Microsoft Defender proporcionan interfaces dedicadas para monitorizar la ejecución, tasa de fallos de consulta y volumen de disparo de sus reglas. Y frente a las métricas de alerta, conviene interiorizar dos máximas innegociables de Detection Engineering:
Silencio no significa calidad.
Y de forma complementaria:
Una regla que nunca alerta puede ser excelente. O puede estar rota.
Si una regla diseñada para detectar inyecciones de memoria en procesos del sistema lleva 180 días con cero alertas, existen dos interpretaciones posibles: o ningún atacante ha ejecutado esa técnica en la red, o la actualización del agente EDR modificó el nombre del evento y la regla está consultando una tabla vacía. La única manera de comprobarlo es mediante pruebas periódicas de emulación adversarial.
Paso 15. Utiliza el triage como retroalimentación continua #
Aquí es donde el rol del Detection Engineer se conecta directamente con el trabajo diario de los analistas de operaciones de seguridad durante el triage de alertas SOC. Cuando una regla entra en producción, genera señales que son consumidas, contrastadas y evaluadas en la trinchera técnica.
Supongamos que una detección dispara 50 alertas a lo largo de una semana. Durante el proceso de triaje, los analistas clasifican los incidentes:
- 30 alertas: correspondientes a una automatización corporativa del departamento de IT.
- 10 alertas: originadas por una herramienta de asistencia remota recién homologada.
- 7 alertas: causadas por tareas puntuales de administración de sistemas.
- 3 alertas: constituyen eventos genuinamente anómalos que requirieron investigación profunda de nivel 2.
Un equipo desorganizado aceptaría este escenario como una molestia inevitable y continuaría cerrando manualmente las 47 alertas benignas cada semana. Un SOC maduro, en cambio, utiliza este resultado como información de retroalimentación crítica para Detection Engineering:
Al analizar los 3 casos relevantes, el Detection Engineer puede descubrir que la actividad sospechosa compartía características no contempladas en la versión inicial:
Office ──► PowerShell ──► Línea de comandos codificada en Base64 (-enc / -EncodedCommand)Con esa información, el ingeniero puede crear una regla derivada de alta fidelidad con severidad crítica y afinar la regla general mediante excepciones precisas. El analista consume detecciones, pero también es el principal motor para perfeccionarlas.
Tuning, excepción y suppression no son lo mismo #
Cuando una detección genera demasiado ruido, los analistas inexpertos suelen utilizar indistintamente los términos “hacer tuning”, “poner una excepción” o “silenciar la regla”. Sin embargo, en arquitecturas defensivas modernas representan tres operaciones completamente distintas que actúan en capas diferentes del ciclo de detección:
| Concepto | En qué consiste técnicamente | Ejemplo práctico | Cuándo debe aplicarse |
|---|---|---|---|
| Tuning (Ajuste analítico) | Modificar la lógica nuclear de la consulta porque la regla original fue formulada de manera demasiado amplia o genérica. | Cambiar la condición genérica process.name == "powershell.exe" por la relación estricta parent.name in ("winword.exe", "excel.exe") and process.name == "powershell.exe". |
Cuando la regla confunde comportamientos benignos normales con amenazas debido a un diseño inicial deficiente. |
| Excepción (Exception) | Mantener la lógica principal intacta, pero añadir una exclusión quirúrgica para un proceso legítimo y autorizado con atributos inmutables. | Permitir la ejecución de powershell.exe desde Excel únicamente si el equipo es FIN-SRV-01, el script es C:\ERP\Sync.ps1 y el usuario es svc_erp. |
Cuando la lógica es 100% correcta y necesaria, pero existe una excepción corporativa conocida, justificada y documentada. |
| Suppression (Supresión / Deduplicación) | Permitir que la regla evalúe y coincida, pero agrupar o no generar alertas duplicadas para la misma entidad en una ventana de tiempo. | Si un servidor dispara la misma alerta de escaneo de puertos 500 veces en 10 minutos, generar un único incidente agrupado por host. | Cuando el evento es legítimamente investigable pero se repite en ráfagas que saturarían la cola de tickets del SOC. |
Elastic Security formaliza explícitamente esta separación técnica en su arquitectura de reglas, diferenciando entre la definición de consulta, las listas de excepciones asociadas y las reglas de supresión de alertas en el motor de eventos. No intentes solucionar todos los problemas de volumen añadiendo exclusiones indiscriminadas en una lista gigante; cada exclusión sin control es una invitación directa a la evasión.
Caso práctico completo: construir una detección en 12 fases #
Para consolidar la metodología, recorramos el ciclo de vida completo de una detección desde su concepción inicial hasta su despliegue operativo en el SOC.
Fase 1: Identificación del problema
Durante la investigación de un incidente reciente, el equipo detectó que un usuario abrió un documento malicioso que utilizó macros VBA para iniciar un proceso hijo de PowerShell con el fin de descargar una carga útil de segundo estadio. Queremos visibilidad permanente sobre este patrón de ejecución.
Fase 2: Formulación de la hipótesis
En estaciones de trabajo estándar de usuarios corporativos, las aplicaciones de Microsoft Office no tienen motivos legítimos de negocio para invocar consolas de comandos o intérpretes de scripting. Cuando esto ocurre, existe una probabilidad muy alta de explotación de vulnerabilidades o ejecución de macros de ataque.
Fase 3: Verificación de telemetría requerida
Comprobamos en nuestro repositorio de logs si disponemos de los campos requeridos:
timestamp: hora precisa del evento.host.name/Computer: equipo donde ocurrió.user.name: cuenta que ejecutó la aplicación.process.parent.name: nombre del proceso padre (winword.exe,excel.exe, etc.).process.name: nombre del ejecutable hijo (powershell.exe).process.command_line: argumentos completos pasados al proceso.
Fase 4: Formulación de la lógica inicial
Escribimos la condición conceptual abstracta:
parent.process.name in ("WINWORD.EXE", "EXCEL.EXE", "POWERPNT.EXE")
AND
process.name in ("powershell.exe", "cmd.exe", "wscript.exe", "cscript.exe")
Fase 5: Ejecución sobre datos históricos (Backtesting)
Lanzamos la consulta sobre los últimos 30 días de eventos en el SIEM. La sentencia devuelve 42 resultados. En este instante no sabemos si es un volumen adecuado o una lluvia de ruido; procedemos a analizarlos individualmente.
Fase 6: Clasificación de resultados
Al desglosar las 42 coincidencias históricas descubrimos:
- 25 eventos: causados por una macro corporativa antigua del departamento de Finanzas que actualiza tipos de cambio.
- 10 eventos: generados por una herramienta interna de despliegue de software que utiliza Excel como plantilla.
- 5 eventos: provocados por una prueba de penetración autorizada realizada la semana anterior.
- 2 eventos: ejecuciones aisladas en equipos comerciales que nadie puede explicar.
Fase 7: Estudio y acotación de la actividad legítima
Analizamos los 25 eventos de Finanzas. Observamos que siempre ejecutan el script C:\Finanzas\Tools\actualizar_tasas.ps1, sobre dos estaciones de trabajo específicas (FIN-PC01 y FIN-PC02), bajo la cuenta usr_tesoreria. Documentamos una excepción estricta que exija la coincidencia de los tres factores simultáneamente.
Fase 8: Repetición de la prueba analítica
Volvemos a ejecutar la consulta histórica aplicando la excepción parametrizada. El volumen se reduce a 17 resultados. No buscamos forzar la cuenta a cero; buscamos que cada evento restante sea justificable y genere una investigación real.
Fase 9: Incorporación de contexto operativo
Diseñamos la alerta proyectando las entidades clave (Host, Usuario, Proceso Padre con PID, Proceso Hijo con línea de comandos completa) y redactamos la Investigation Guide:
“1. Identificar el archivo ofimático abierto inmediatamente antes de la ejecución examinando eventos de lectura de disco. 2. Revisar si la línea de comandos de PowerShell incluye flags de evasión (-WindowStyle Hidden, -EncodedCommand). 3. Analizar conexiones salientes de red establecidas por el proceso hijo en los 10 minutos posteriores.”
Fase 10: Validación en entorno de pruebas
En una máquina virtual aislada con el agente de telemetría activo, ejecutamos un documento Word de prueba que invoca una ventana de comandos interactiva. Comprobamos que el evento llega al SIEM en menos de 2 minutos, la regla se activa, genera la alerta con la severidad correcta y los campos proyectados coinciden exactamente con la prueba.
Fase 11: Despliegue en producción controlada
Publicamos la regla inicialmente en modo de auditoría silenciosa durante 7 días para monitorizar si surgen nuevos comportamientos legítimos no identificados en el backtesting. Al verificar estabilidad, activamos el enrutamiento directo hacia la cola de incidentes del SOC.
Fase 12: Revisión periódica y mantenimiento
Dos meses después, el departamento de Finanzas migra su macro a una API web moderna y retira el script antiguo de PowerShell. El Detection Engineer elimina la excepción correspondiente del sistema, cerrando un potencial vector de evasión y manteniendo limpia la regla.
Laboratorio práctico: cómo construir tu primera detección sin malware #
No necesitas descargar muestras peligrosas de ransomware ni exploits avanzados para entrenar tus habilidades de ingeniería de detección. De hecho, construir detecciones sobre comportamientos benignos pero estrictamente controlados es el método formativo más sólido para dominar la telemetría.
Objetivo del laboratorio
Detectar la siguiente jerarquía de ejecución anómala en un entorno Windows:
powershell.exe ──► cmd.exe ──► whoami.exeEsta cadena simula el comportamiento clásico de un script malicioso que ejecuta una subconsola de comandos para enumerar los privilegios de la cuenta comprometida.
Paso 1. Generar la actividad controlada
Abre una consola de PowerShell en tu equipo de pruebas y ejecuta la siguiente instrucción:
Start-Process cmd.exe -ArgumentList '/c whoami'Paso 2. Recolectar la telemetría
Para observar la evidencia necesitas una fuente de eventos de creación de procesos:
- Sysmon: Event ID 1 (Process Creation), que registra de forma nativa los hashes, linajes e identidades de usuario.
- Windows Event Logs: Event ID 4688 (A new process has been created), asegurando que la política de auditoría tenga habilitada la inclusión de la línea de comandos.
- Sensores de telemetría EDR corporativa.
Paso 3. Responder las preguntas de ingeniería
- ¿Aparece el evento en los logs? Busca la ejecución de
whoami.exefiltrando por la marca de tiempo de la prueba. - ¿Puedes reconstruir el árbol de linaje? Verifica si el evento de
whoami.exetiene comoParentImageacmd.exe, y a su vez si el evento decmd.exetiene como proceso padre apowershell.exe. - ¿Qué campos precisos necesitas correlacionar?
process.name,process.parent.name,process.command_line,user.nameyhost.name.
Paso 4. Redactar y validar la lógica
Formula una consulta analítica que busque procesos whoami.exe cuyo padre sea cmd.exe ejecutado con el flag /c. A continuación, realiza pruebas negativas:
- Ejecuta
cmd.exe /c whoamidirectamente desde el menú Inicio (el padre seráexplorer.exe, nopowershell.exe). Comprueba que la regla permanezca en silencio. - Ejecuta
powershell.exe -Command "Get-Process". Comprueba que tampoco dispare la alarma.
Al verificar que tu regla detecta la prueba positiva y rechaza con éxito las pruebas negativas, habrás creado tu primera detección validada con rigor de ingeniería.
Formación especializada en Blue Team & SOC #
Especialízate en Defensa Activa y Operaciones SOC
Dominar la ingeniería de detección requiere comprender a fondo cómo operan los adversarios, cómo interpretar telemetría de sistemas a bajo nivel y cómo construir alertas que aporten valor real a los analistas de seguridad.
Explorar la Ruta Profesional Blue Team & SOCUna detección debe fallar de forma visible #
Imagina el siguiente escenario habitual en operaciones defensivas: un agente recolector de Sysmon en un grupo crítico de servidores deja de transmitir eventos debido a una actualización defectuosa del kernel o a un corte de red. La regla analítica que monitorea inyecciones de memoria en esos servidores continúa ejecutándose puntualmente cada 5 minutos.
En el panel del SIEM, el contador muestra:
Alertas generadas: 0¿Significa esto que la infraestructura está completamente protegida? En absoluto. Significa algo mucho más peligroso: el equipo defensivo está ciego sin saberlo.
Uno de los principios de diseño más maduros en Detection Engineering establece que los mecanismos analíticos deben contar con observabilidad intrínseca:
Una arquitectura de detección madura debe permitir diferenciar entre «no hubo actividad coincidente» y «no recibimos la telemetría necesaria para evaluar el comportamiento».
Para conseguir que los fallos sean visibles, los equipos implementan dos capas de control:
- Reglas de integridad de ingesta (Data Ingestion Health Rules): Consultas de supervisión tipo heartbeat que alertan si una fuente habitual (como los controladores de dominio o los servidores web) deja de indexar eventos durante un periodo superior a su umbral normal.
- Métricas de cobertura por sensor: Paneles que cruzan el inventario de activos con las tablas de telemetría activas en el SIEM para detectar agentes caídos o desactualizados antes de que un atacante aproveche el vacío.
Cobertura ATT&CK vs. cobertura real: la trampa de las casillas verdes #
En los informes ejecutivos de ciberseguridad es frecuente encontrar mapas de MITRE ATT&CK para analistas SOC con decenas de celdas coloreadas en verde intenso. Supongamos que tu organización dispone de una regla etiquetada con la técnica:
T1059.001 — Command and Scripting Interpreter: PowerShell¿Significa esa casilla verde que la organización detecta cualquier uso malicioso de PowerShell en la red?
Rotundamente no. Significa únicamente que existe una lógica concreta implementada para observar una manifestación muy específica de esa técnica. Entre esa regla y la realidad de una intrusión adversaria pueden existir múltiples brechas defensivas:
- Variantes de ejecución no cubiertas: La regla detecta
powershell.exepero no inspecciona invocaciones depowershell_ise.exe, consolas no interactivas o binarios personalizados que cargan directamente la libreríaSystem.Management.Automation.dll(ataques unmanaged PowerShell). - Técnicas de ofuscación: Invocación mediante sintaxis en minúsculas y mayúsculas alternadas, variables de entorno fragmentadas o scripts codificados en Base64.
- Sensores no desplegados: El evento se detecta en puestos de trabajo pero los servidores de bases de datos carecen de agente de auditoría de línea de comandos.
- Evidencia perdida: Registros truncados por desbordamiento de búfer en los canales locales del sistema operativo.
El axioma de la cobertura granular
Una matriz coloreada genera una ilusión de inmunidad si se interpreta como protección absoluta. Por eso, en Detection Engineering rigen dos reglas axiomáticas:
1 técnica no equivale a 1 regla.
1 regla no equivale a cobertura completa.
Una técnica compleja como Credential Dumping (T1003) puede materializarse mediante lectura de memoria en lsass.exe, copias de seguridad de la base de datos NTDS.dit, extracción de claves en el Registro de Windows o volcado de credenciales en navegadores web. Cubrir esa técnica requiere múltiples analíticas independientes basadas en componentes de datos distintos.
Precisamente por esta razón, MITRE ATT&CK reestructuró su contenido defensivo en sus versiones v18 y v19: los antiguos Data Sources quedaron deprecados y dieron paso al modelo moderno de Detection Strategies y Analytics vinculados a Data Components específicos, permitiendo a los ingenieros evaluar analíticas atómicas sin caer en la simplificación de las casillas verdes.
Detection as Code y repositorios Git #
A medida que el catálogo de detecciones de un SOC crece de 10 a cientos de reglas, gestionarlas manualmente mediante formularios en la interfaz gráfica del SIEM se vuelve insostenible. Cualquier edición accidental en producción puede romper una regla crítica sin que quede constancia del autor ni del cambio.
Para resolver este problema, la industria ha adoptado el paradigma de Detection as Code (DaC): tratar las reglas analíticas exactamente igual que los desarrolladores tratan el código fuente de una aplicación.
Estructura típica de un repositorio de Detection as Code:
detections/
  ├── windows/
  │   ├── process_creation/
  │   │   ├── winword_spawns_powershell.yml
  │   │   └── whoami_execution_chain.yml
  │   └── persistence/
  │       └── run_key_modification.yml
  ├── linux/
  │   └── bash_reverse_shell.yml
  └── cloud/
      └── azure_ad_privilege_escalation.yml
Bajo este enfoque, el ciclo de vida de una regla se integra en un flujo de integración continua (CI/CD):
Este flujo proporciona ventajas operativas determinantes: trazabilidad total de quién modificó cada línea, histórico de auditoría mediante git blame, posibilidad de revertir cambios dañinos en segundos (rollback instantáneo) y despliegues homogéneos y reproducibles en múltiples entornos.
Microsoft Defender XDR documenta soporte para sincronizar custom detections a través de repositorios en GitHub o Azure DevOps, y Elastic Security proporciona una API REST integral para gestionar reglas programáticamente. No necesitas implementar una canalización de CI/CD el primer día; pero a medida que tu catálogo madure, Detection as Code será el estándar que garantizará la calidad y el control de tu infraestructura analítica.
¿Dónde entra Sigma en este ecosistema? #
Uno de los mayores dolores de cabeza en ciberseguridad defensiva es la fragmentación tecnológica. Si diseñas la lógica Microsoft Office inicia PowerShell, te encuentras con que:
- En Microsoft Sentinel debes redactarla en KQL.
- En Elastic Security debes formularla en EQL o KQL.
- En Splunk debes escribirla en SPL.
- En QRadar debes utilizar AQL.
Si la empresa cambia de proveedor de SIEM o si necesitas compartir tu detección con una comunidad externa de analistas, tendrías que reescribir manualmente cada regla desde cero.
Aquí es donde entra el estándar de reglas Sigma. Sigma proporciona un formato estructurado en YAML, independiente de cualquier fabricante, para describir comportamientos y firmas de detección:
title: Office Spawning PowerShell
id: 3b6a9c1e-45fa-4c28-971a-e8d91a2bc001
status: stable
description: Detects Microsoft Word or Excel spawning a PowerShell process
logsource:
    category: process_creation
    product: windows
detection:
    selection:
        ParentImage|endswith:
            - '\winword.exe'
            - '\excel.exe'
        Image|endswith: '\powershell.exe'
    condition: selection
falsepositives:
    - Documented administrative macros
level: high
Gracias a compiladores como sigma-cli o pipelines pySigma, esa misma definición puede transformarse automáticamente en sentencias KQL, SPL o Lucene según el backend que utilice tu organización.
Sin embargo, es fundamental comprender una advertencia de ingeniería:
Sigma describe una detección en formato neutral. No garantiza que tus datos puedan ejecutarla correctamente ni convierte una mala hipótesis en una buena detección.
Antes de escribir un archivo YAML debes dominar qué evidencia necesitas, qué campos intervienen y qué excepciones existen en tu red. Profundizamos en toda su sintaxis práctica en nuestra guía completa sobre reglas Sigma.
Los 9 errores más frecuentes en Detection Engineering #
Al analizar programas de detección deficientes en organizaciones reales se repiten sistemáticamente los mismos patrones de fallo. Evitar estos 9 errores te ahorrará cientos de horas de trabajo estéril y evitará la parálisis operativa del SOC:
Catálogo de fallos habituales de diseño analítico
- 01Empezar por la query: Abrir la consola del SIEM y escribir condiciones de sintaxis antes de definir qué comportamiento técnico se desea observar. Produce reglas opacas, frágiles y prácticamente imposibles de mantener.
- 02Detectar herramientas en lugar de comportamientos: Clasificar automáticamente utilidades legítimas del sistema como malignas (
powershell.exe = maloocmd.exe = ataque). PowerShell es una herramienta neutra; la detección debe basarse en el linaje, los parámetros de evasión, el usuario y el contexto. - 03Solucionar todo mediante whitelists indiscriminadas: Resolver cada falso positivo acumulando exclusiones infinitas (
NOT HostA AND NOT UserB AND NOT PathC) sin justificación formal ni fecha de caducidad. Crea autopistas invisibles de evasión para los atacantes. - 04Perseguir ciegamente el objetivo de cero falsos positivos: Exigir que cada regla sea infalible antes de desplegarla. Ciertos comportamientos adversariales de alto impacto justifican asumir un margen operativo de triaje en el SOC.
- 05Confundir cero alertas con éxito defensivo: Asumir que una regla que nunca se activa es una prueba de invulnerabilidad. Como vimos: Silencio no significa calidad; el sensor o el esquema de datos podrían estar rotos.
- 06Mapear ATT&CK a posteriori como adorno decorativo: Asignar etiquetas MITRE al final del proceso para complacer a la dirección sin validar si la telemetría cubre realmente las sub-técnicas adversarias.
- 07Omitir la guía de investigación (Investigation Guide): Generar alertas con títulos alarmistas pero sin instrucciones técnicas que indiquen al analista L1 qué campos comprobar, qué logs correlacionar y qué preguntas responder en los primeros minutos.
- 08Activar respuestas automáticas prematuramente: Asignar acciones drásticas (aislar máquinas, revocar credenciales de red) a reglas recién creadas sin haber validado su fidelidad en datos históricos y auditoría silenciosa.
- 09No versionar ni auditar las modificaciones: Editar sentencias analíticas directamente en producción sin control de cambios en Git. Si las alertas caen un 90%, nadie sabrá si la regla mejoró o si quedó completamente inservible.
Qué debe saber un Detection Engineer: perfil y competencias #
Detection Engineering es un rol híbrido y altamente especializado que se sitúa en la intersección entre la investigación de seguridad, la administración de sistemas y la ingeniería de software. No requiere memorizar todas las plataformas del mercado, pero exige un dominio sólido de fundamentos técnicos inmutables:
| Área técnica | Conocimientos fundamentales exigidos | Aplicación práctica en el SOC |
|---|---|---|
| Internals de Sistemas Operativos | Arquitectura de procesos, linaje padre-hijo, APIs nativas (Win32, syscalls), mecanismos de autenticación (Kerberos, NTLM, PAM) y estructuras de memoria en Windows y Linux. | Entender qué huellas deja un atacante al ejecutar payloads o migrar procesos antes de que toque el disco. |
| Arquitectura de Logs y Telemetría | Estructuras de eventos en Windows Event Logs, Sysmon, Auditd, registros de cortafuegos y sensores endpoint. | Saber con certeza qué ID de evento y qué atributos contienen la evidencia objetiva de un vector de ataque. |
| Consultas Analíticas y SIEM | Dominio de lenguajes analíticos (KQL, SPL, EQL, SQL) y arquitecturas de búsqueda e indexación en plataformas SIEM. | Escribir consultas eficientes que ejecuten en segundos sin sobrecargar la infraestructura analítica. |
| Modelado Adversarial | Metodología táctica en MITRE ATT&CK, Cyber Kill Chain y matriz de amenazas reales. | Diseñar estrategias de detección alineadas con las tácticas y procedimientos utilizados por los actores de amenaza. |
| Automatización y Código | Scripting avanzado en Python y PowerShell, control de versiones con Git y nociones de pipelines CI/CD. | Implementar el flujo de Detection as Code, emular ataques de prueba y gestionar el catálogo mediante API. |
| Mentalidad Operativa de Triaje | Experiencia práctica en investigación de incidentes en niveles L1/L2. | Construir alertas accionables con Investigation Guides que reduzcan la carga de trabajo y el estrés de los analistas. |
Dentro de la progresión profesional del Blue Team, la ingeniería de detección suele alcanzarse tras haber ejercido como analista de operaciones. Primero aprendes a investigar las señales que otros construyeron; después comprendes sus deficiencias y adquieres el criterio necesario para construir señales mucho mejores.
Preguntas frecuentes sobre Detection Engineering #
¿Qué es Detection Engineering en ciberseguridad?
Es la disciplina de ingeniería encargada de investigar amenazas, analizar telemetría, diseñar lógica de detección, validar reglas mediante pruebas positivas y negativas, documentar guías de triaje y mantener el ciclo de vida de las alertas en plataformas SIEM, EDR y XDR.
¿Qué hace un Detection Engineer en su trabajo diario?
Un Detection Engineer investiga nuevas técnicas adversarias, evalúa la cobertura de telemetría de la red, traduce comportamientos en consultas analíticas, elimina falsos positivos mediante tuning riguroso, automatiza el despliegue de reglas mediante Git (Detection as Code) y trabaja junto a los analistas del SOC para optimizar el contexto de los incidentes.
¿Detection Engineering es lo mismo que Threat Hunting?
No. Threat Hunting es una disciplina proactiva y orientada a hipótesis que busca manualmente intrusiones existentes que evadieron las defensas. Detection Engineering toma los hallazgos validados durante las cacerías de amenazas y los convierte en reglas automáticas y permanentes para la monitorización continua del SOC.
¿Detection Engineering es lo mismo que escribir reglas Sigma?
No. Sigma es un estándar de representación neutral en formato YAML para compartir firmas de detección. Detection Engineering es un proceso metodológico completo que engloba análisis de comportamiento, validación de telemetría, pruebas de caja negra, ajuste de falsos positivos, documentación operativa y retroalimentación con el SOC.
¿Debo aprender KQL o SPL obligatoriamente para trabajar en este campo?
Aprender un lenguaje analítico concreto (como KQL en Microsoft Sentinel/Defender o SPL en Splunk) es imprescindible para interactuar con la plataforma de tu empresa. Sin embargo, aprender la sintaxis de un lenguaje sin comprender la telemetría del sistema operativo produce reglas inútiles. Lo prioritario es entender qué evidencia deja el sistema; la sintaxis de la consulta se aprende rápidamente.
¿Cómo se mide si una regla de detección es de alta calidad?
Una regla es de alta calidad si detecta de forma consistente el comportamiento adversarial previsto, genera suficiente contexto operativo para que un analista L1 inicie la investigación en menos de 5 minutos, mantiene una tasa baja de falsos positivos, resiste variaciones superficiales de ejecución y cuenta con pruebas unitarias documentadas.
¿Una buena regla debe tener estrictamente cero falsos positivos?
No necesariamente. Exigir cero falsos positivos provocaría reglas tan hiperespecíficas que los atacantes las evadirían con ligeras variaciones de sintaxis. El objetivo de Detection Engineering es maximizar el valor de la señal en relación con el coste del tiempo de triaje que requiere del analista.
¿Qué diferencia práctica existe entre tuning y una excepción?
El tuning modifica la lógica principal de la regla porque fue redactada de forma demasiado amplia (por ejemplo, exigir una relación padre-hijo específica). Una excepción mantiene la lógica intacta pero excluye quirúrgicamente un proceso corporativo legítimo e identificado mediante condiciones estrictas (equipo, usuario, hash y ruta).
¿Cómo se utiliza MITRE ATT&CK en el diseño de detecciones?
Se utiliza para estructurar el modelo de amenazas y mapear los comportamientos que se pretenden vigilar. Desde ATT&CK v18 y v19, se emplean las Detection Strategies y Analytics vinculadas a Data Components para diseñar analíticas atómicas basadas en telemetría específica, evitando asumir falsamente que una regla cubre por completo una técnica.
¿Qué debería aprender después de dominar los fundamentos de Detection Engineering?
El paso inmediato recomendado es estudiar reglas Sigma para estructurar y portar detecciones entre diferentes tecnologías de seguridad, así como profundizar en la emulación de adversarios (Atomic Red Team) para automatizar la validación continua de tu catálogo.
Conclusión: de consultas crudas a productos de ingeniería #
Una detección mal concebida puede ser impecable desde el punto de vista sintáctico. Puede compilar sin advertencias en la consola del SIEM, ejecutar puntualmente cada 5 minutos y devolver docenas de eventos a la cola de incidentes.
Y sin embargo, puede ser completamente inútil para la seguridad de la empresa.
Una buena detección no empieza en el editor de código del SIEM. Comienza mucho antes, respondiendo con rigor analítico a cuatro preguntas fundamentales:
1. ¿Qué comportamiento adversarial quiero observar?
2. ¿Qué evidencia objetiva e inmutable deja ese comportamiento en el sistema?
3. ¿Dispongo de la telemetría necesaria en mis sensores para capturar esa evidencia?
4. ¿Cómo modelo esa evidencia mediante lógica analítica sin ahogar al analista en ruido?
A partir de ahí comienza el trabajo de ingeniería: someter la lógica a pruebas positivas y negativas, documentar la ficha técnica con su Investigation Guide, desplegar de forma gradual en modo auditoría, monitorizar la salud de la regla y escuchar activamente el feedback de los analistas que realizan el triaje diario.
Detection Engineering no consiste en acumular miles de reglas en el repositorio para inflar métricas vacías de cobertura. Consiste en transformar el torrente crudo de telemetría en señales limpias, fiables y accionables que permitan a los defensores anticipar y neutralizar intrusiones reales antes de que causen daños irreparables.
Una query que devuelve resultados no es necesariamente una buena detección.
En el siguiente artículo de esta serie llevamos esta metodología a la práctica mediante el formato estándar de la industria: aprende a estructurar y traducir tus firmas con nuestra guía completa sobre Reglas Sigma: qué son, cómo funcionan y cómo utilizarlas.