Traceroute en Linux: guía completa de Traceroute, Tracepath, rutas y diagnóstico de red
Cuando una conexión falla, la pregunta útil no es solo “¿Internet funciona?”, sino qué ruta intenta usar tu equipo, qué sondas reciben respuesta y qué puedes concluir realmente de ellas. En esta guía aprenderás a combinar traceroute, tracepath, ip route y mtr en Linux sin confundir una traza con la topología física, una respuesta lenta con latencia del enlace o un asterisco con una caída.
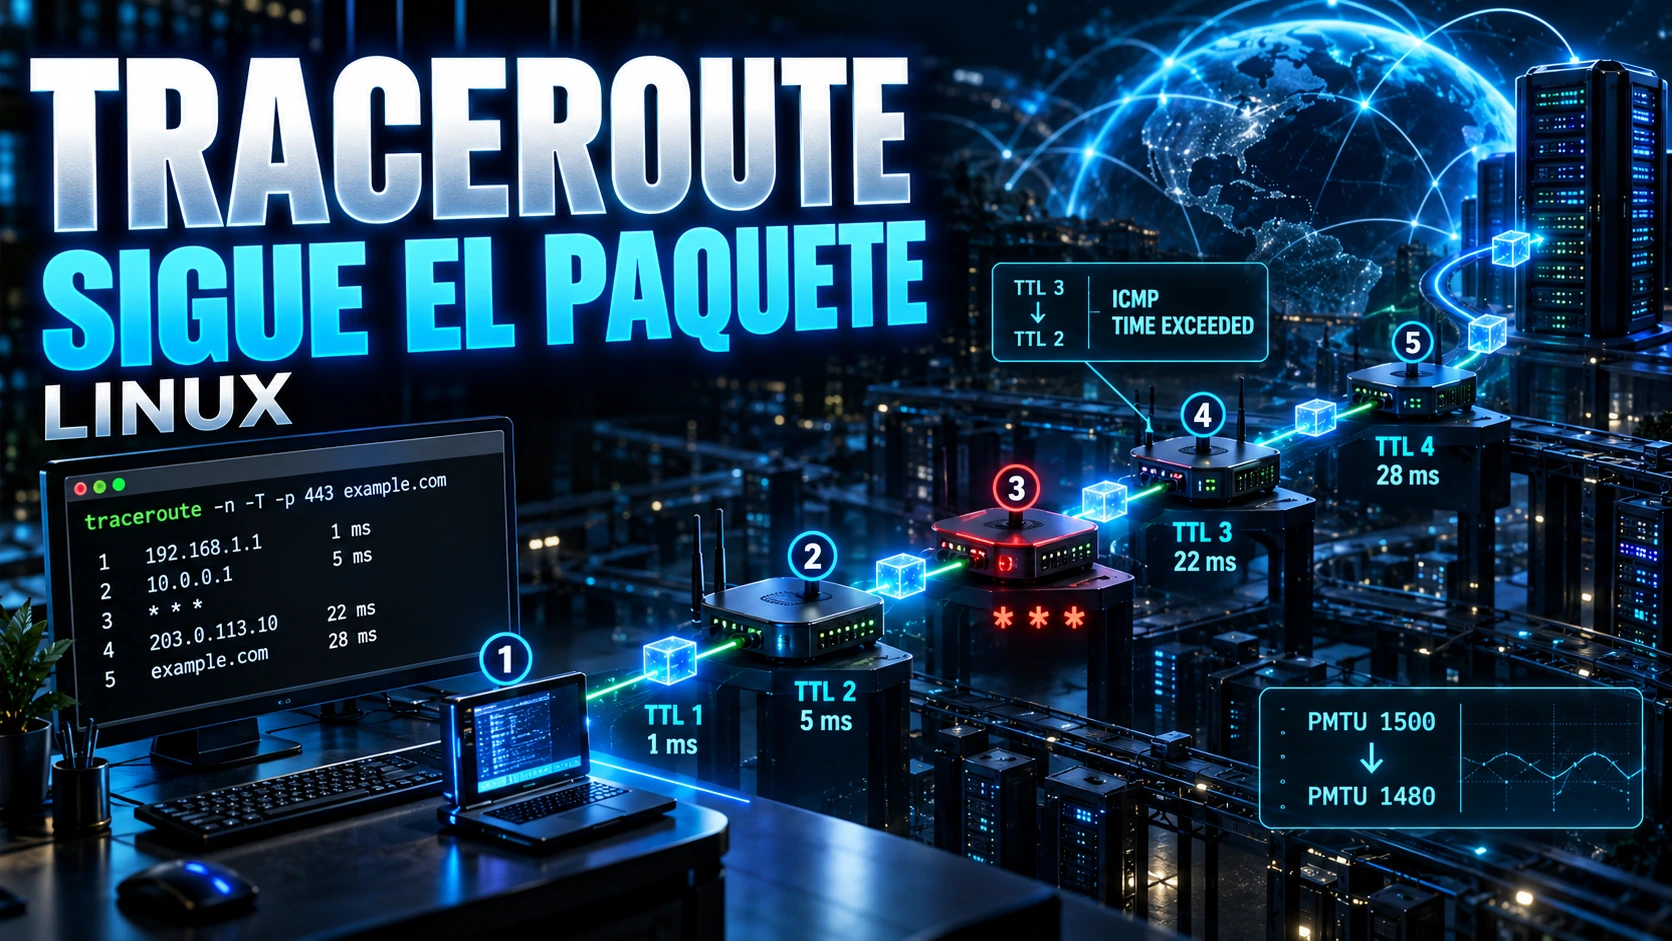
Idea clave: traceroute no “dibuja Internet”. Observa qué sistemas responden a sondas con un TTL —o Hop Limit en IPv6— progresivamente mayor. La salida es una medición desde tu origen, con ese método de sonda y en ese momento. Antes de culpar a un operador, comprueba qué ruta elegiría tu propio kernel con ip route get. Si necesitas reforzar la base, vuelve al pilar de Redes para ciberseguridad y a Linux para ciberseguridad.
Respuesta rápida: comandos esenciales #
Esta tabla sirve como referencia operativa. Los resultados dependen de la implementación instalada, la política de red y el protocolo de las sondas.
| Objetivo | Comando |
|---|---|
| Traza estándar | traceroute example.com |
| Evitar DNS inverso | traceroute -n example.com |
| Forzar IPv4 / IPv6 | traceroute -4 example.com / traceroute -6 example.com |
| Sondas ICMP Echo | traceroute -I example.com |
| Sondas TCP SYN | traceroute -T example.com |
| TCP hacia HTTPS | traceroute -T -p 443 example.com |
| Máximo 15 saltos | traceroute -m 15 example.com |
| Una sonda por salto | traceroute -q 1 example.com |
| Reducir sondas simultáneas | traceroute -N 1 example.com |
| Timeout máximo explícito | traceroute -w 5 example.com |
| Intentar descubrir MTU | traceroute --mtu example.com |
| Tracepath y PMTU | tracepath -n example.com |
| Tabla de rutas | ip route |
| Ruta que resolvería el kernel | ip route get 1.1.1.1 |
| MTR, informe de 20 ciclos | mtr -rw -c 20 example.com |
¿Qué es Traceroute? #
traceroute es una herramienta de diagnóstico que infiere parte del camino de red haciendo que diferentes sondas caduquen a distancias sucesivas. Los equipos que generan una respuesta permiten observar una dirección o interfaz asociada a ese salto.
1  192.168.1.1       1.2 ms   1.1 ms   1.1 ms
2  10.10.0.1         5.8 ms   5.7 ms   5.9 ms
3  203.0.113.10     12.4 ms  12.0 ms  12.3 ms
4  198.51.100.20    22.5 ms  23.0 ms  22.7 ms
5  example.com      28.3 ms  28.0 ms  28.1 ms
La traza no demuestra la topología física, no identifica necesariamente un equipo único por línea y no garantiza que otra conexión, otro protocolo o una ejecución posterior atraviesen exactamente los mismos elementos. NAT, MPLS, túneles, políticas de routing, ECMP y filtrado pueden cambiar lo que ves.
Cómo funciona Traceroute realmente: TTL, Hop Limit y respuestas ICMP #
En IPv4, cada router que reenvía un paquete reduce su TTL. Si al reenviarlo el TTL expira, el paquete se descarta y, para tráfico no multicast en las condiciones definidas por RFC 1812, el router genera ICMP Time Exceeded, código 0. En IPv6 el concepto equivalente es Hop Limit; cada nodo que reenvía lo decrementa y, al llegar a cero, ICMPv6 puede revelar ese punto del camino.
El ciclo de sondas progresivas
- TTL/Hop Limit = 1: la primera sonda expira en el primer salto que la reenvía.
- Valor = 2: la siguiente puede alcanzar un salto más antes de expirar.
- Valores sucesivos: la herramienta repite el proceso hasta obtener una respuesta del destino o alcanzar su límite.
En la implementación Traceroute for Linux 2.1.6, el máximo predeterminado es 30 saltos y se envían 3 sondas por valor de TTL. Esos valores son defaults de esa implementación, no propiedades del protocolo IP.
Estructura de salida y qué significa realmente el RTT #
4 router.example.net (203.0.113.20) 20.481 ms 20.722 ms 20.601 ms- 4: valor de TTL/Hop Limit de esas sondas y posición observada en la traza.
- router.example.net: nombre obtenido por resolución inversa si está disponible.
- 203.0.113.20: dirección de la interfaz/origen que respondió; no es una prueba de identidad física del router completo.
- 20.481 ms…: RTT de cada sonda desde tu equipo hasta quien responde y de vuelta.
El RTT de un salto no es la latencia de “ese enlace”. Incluye el camino de ida de la sonda, el tratamiento de la respuesta y el camino de retorno. Un salto intermedio puede contestar lentamente a tráfico de control mientras sigue reenviando tráfico con normalidad. Si un aumento aparece en un salto y también persiste hasta el destino, es una señal más útil, pero conviene confirmarla con varias mediciones y métodos.
¿Qué significan los asteriscos (* * *) en Traceroute? #
Un asterisco significa algo mucho más concreto de lo que suele suponerse: esa sonda no produjo una respuesta utilizable antes del timeout.
- el dispositivo puede limitar o no generar respuestas ICMP;
- un firewall puede filtrar la sonda o la respuesta;
- la respuesta puede perderse o tomar un camino de retorno diferente;
- el método de sonda elegido puede no atravesar la misma política que el servicio que estás diagnosticando;
- la propia concurrencia de sondas puede activar rate limiting.
Si aparecen asteriscos y después vuelven a responder saltos posteriores —o el destino—, tienes evidencia de que al menos esas sondas posteriores siguieron avanzando. No demuestra que el salto silencioso esté “perfectamente” sano; demuestra que su silencio no basta para diagnosticar una caída.
Linux Traceroute vs. Windows tracert: UDP vs. ICMP #
Las herramientas persiguen un objetivo parecido, pero sus sondas predeterminadas no son iguales.
Diferencia de método
Traceroute for Linux: el método tradicional usa UDP a puertos de destino “improbables”, comenzando en 33434 e incrementándolos. Al alcanzar el destino, normalmente espera una respuesta ICMP Port Unreachable.
Windows tracert: Microsoft documenta el uso de ICMP Echo Request —o ICMPv6— con TTL/Hop Limit creciente.
Por eso dos trazas desde el mismo punto pueden diferir: las políticas de firewall, ACL, balanceo o routing pueden tratar UDP, ICMP y TCP de forma distinta. La diferencia entre salidas no prueba por sí sola cuál de las dos representa “la ruta real” de una aplicación.
Parámetros esenciales: -n, IPv4/IPv6 y control de sondas #
1. Evitar resolución inversa: -n
traceroute -n example.comEvita esperar consultas PTR al mostrar los resultados. Es útil cuando precisamente sospechas de DNS o quieres comparar tiempos sin añadir la demora visual de resolver nombres.
2. Comparar IPv4 e IPv6: -4 y -6
traceroute -4 example.com
traceroute -6 example.com
No presupongas que ambas familias siguen el mismo tránsito. Ejecutarlas de forma explícita ayuda a separar problemas por familia IP.
3. Ajustar saltos, consultas y concurrencia
traceroute -m 15 example.com   # máximo 15 saltos
traceroute -q 1 example.com    # una sonda por salto
traceroute -N 1 example.com    # una sonda simultánea
traceroute -w 5 example.com    # timeout máximo explícito
-q controla cuántas sondas se imprimen por salto; -N controla cuántas se mantienen simultáneamente. Reducir concurrencia puede ayudar cuando hay rate limiting o respuestas desordenadas.
Sondas UDP, ICMP y TCP (puerto 443) #
Cambiar el método de sonda es una de las pruebas más útiles cuando la traza tradicional queda filtrada.
UDP tradicional
traceroute -n example.comEs el método predeterminado tradicional de Traceroute for Linux y está permitido para usuarios sin privilegios en la implementación actual.
ICMP Echo: -I
traceroute -I example.comLa posibilidad de usarlo sin privilegios depende del kernel y de la configuración de sockets ICMP del sistema. Evita convertir sudo en requisito universal.
TCP SYN: -T
traceroute -T -p 443 example.comPrueba el camino con sondas TCP al puerto 443. Es útil para comparar cómo los controles intermedios tratan tráfico con una combinación protocolo/puerto similar a HTTPS, pero no ejecuta HTTPS ni valida la aplicación. La ruta de una sonda tampoco garantiza que todas las conexiones futuras sigan exactamente el mismo ECMP.
Tabla de rutas del kernel: ip route e ip route get #
Antes de mirar Internet, verifica qué decisión de routing toma tu propio host. El comando histórico route de net-tools está en gran medida sustituido en Linux moderno por ip route de iproute2.
# Tabla principal visible
ip route

# Ruta por defecto
ip route show default

# Resolver la ruta para un destino sin enviar el paquete
ip route get 1.1.1.1
Por qué ip route get es tan útil
La documentación de iproute2 lo describe como una resolución de ruta tal como la ve el kernel. Puede mostrar next hop, interfaz y dirección de origen seleccionada. No equivale a ip route show y no envía el paquete al destino.
Si hay policy routing, VRF, múltiples interfaces, VPN o varias puertas de enlace, este paso evita atribuir a la red exterior una decisión que en realidad está tomando tu host.
Traceroute vs. Tracepath: Path MTU (PMTU) en acción #
tracepath, parte de iputils, combina trazado y descubrimiento de MTU usando UDP y no requiere privilegios de superusuario. traceroute también dispone de --mtu, que activa su mecanismo de descubrimiento de MTU.
| Característica | traceroute | tracepath |
|---|---|---|
| Inferir saltos | Sí | Sí |
| Métodos de sonda | UDP, ICMP, TCP y otros según implementación | UDP |
| PMTU | --mtu | Función integrada |
| Privilegios | Dependen del método/capacidades del sistema | No requiere superusuario |
| IPv4 / IPv6 | -4 / -6 | -4 / -6 |
Qué es realmente la Path MTU
La PMTU es el tamaño máximo de paquete que puede atravesar un camino sin necesitar fragmentación en ese trayecto; está limitada por el enlace con menor MTU de la ruta. Para IPv4, PMTUD está definido en RFC 1191; para IPv6, RFC 8201.
tracepath -n example.com
traceroute --mtu example.com
Una reducción de PMTU puede estar relacionada con túneles, encapsulación u otros enlaces con MTU menor, pero no existe un valor universal para “VPN” o “PPPoE” que puedas asumir sin medir. Si aparece un problema de PMTU, la solución puede estar en endpoints, túneles, firewalls o configuración de transporte; no concluyas automáticamente que debes aplicar MSS clamping.
Asimetría de rutas, balanceo de carga y cinco errores frecuentes #
La ruta de ida y la de retorno pueden ser diferentes. Además, un entorno con ECMP puede enviar sondas o flujos por next hops distintos. Por eso una traza no permite reconstruir por sí sola el camino inverso ni una topología física estable.
Cinco errores que degradan un diagnóstico
- “* * * significa caída”. Solo significa que no llegó una respuesta utilizable dentro del timeout.
- “El RTT del salto es la latencia de ese enlace”. Es un RTT completo de esa sonda y su respuesta.
- “Una traza es el mapa físico de la red”. Muestra respondedores observados, no cableado, chasis ni todos los elementos del plano de datos.
- “Un solo protocolo basta”. Compara UDP, ICMP o TCP cuando el filtrado puede cambiar el resultado.
- “Si falla fuera, el problema es del operador”. Revisa primero routing local, interfaz, VPN y primer salto.
En conexiones inalámbricas, variación o pérdida ya en el primer salto puede justificar revisar el segmento local antes de interpretar el resto. Para esa capa, consulta Wi‑Fi para ciberseguridad.
Aprende direccionamiento IP, puertas de enlace, routing y protocolos de transporte para diagnosticar redes con solidez.
Diagnóstico dinámico con MTR (My Traceroute) #
mtr combina la idea de traceroute con mediciones repetidas y mantiene estadísticas por salto.
# Interactivo
mtr example.com

# Informe de 20 ciclos
mtr -rw -c 20 example.com
La columna Loss% describe pérdidas de respuestas a las sondas de MTR; no debe presentarse automáticamente como pérdida del tráfico reenviado. El propio proyecto MTR advierte que routers intermedios pueden no responder o limitar ICMP.
Un patrón donde un salto intermedio muestra pérdida pero los saltos posteriores y el destino no la reproducen suele apuntar a tratamiento de las respuestas de control, no a pérdida equivalente del tráfico que atraviesa ese equipo. En cambio, degradación que aparece y persiste hasta el destino merece más investigación. Incluso entonces, confirma con distintas ventanas temporales, destinos y, cuando sea relevante, métodos de sonda diferentes.
Traceroute en ciberseguridad: Blue Team y Red Team #
Traceroute es útil en seguridad cuando se trata como una fuente de evidencia parcial, no como un veredicto.
- Blue Team / SOC: comparar cambios de camino, comprobar alcanzabilidad a través de VPN/túneles, investigar qué interfaz o gateway local se usa y contextualizar fallos de conectividad. Una traza anómala puede motivar revisar BGP, SD-WAN, VPN o routing, pero no demuestra por sí sola un BGP hijack.
- Segmentación: puede ayudar a observar hasta dónde responden sondas, pero no “certifica” aislamiento de VLAN o una política de firewall. Esa validación exige combinar configuración, flujos permitidos/denegados y pruebas autorizadas.
- Red Team autorizado: puede aportar pistas sobre fronteras de red y dispositivos que responden a nivel IP. No revela por sí sola topología completa ni demuestra que exista una vía de pivotaje.
Laboratorios prácticos y captura con Wireshark #
Estos laboratorios forman una secuencia pedagógica orientativa de Achirou, no un estándar del sector.
Laboratorio 1 — kernel antes que Internet
ip route get 1.1.1.1
traceroute -n 1.1.1.1
Compara interfaz, gateway y origen elegidos por Linux con el primer tramo visible de la traza.
Laboratorio 2 — cambia el método
traceroute -n example.com
traceroute -I -n example.com
traceroute -T -p 443 -n example.com
Anota qué saltos responden en cada método. Las diferencias son evidencia de tratamiento distinto; no asumas que una salida “gana”.
Laboratorio 3 — observa las sondas con Wireshark
Inicia una captura y ejecuta el traceroute UDP predeterminado. Un filtro de laboratorio razonable es:
icmp || (udp.dstport >= 33434 && udp.dstport <= 33534)El rango es deliberadamente orientativo: si cambias el puerto base, el método o el número de sondas, adapta el filtro. Para profundizar, consulta la guía de filtros y comandos de Wireshark.
Laboratorio 4 — PMTU y comportamiento repetido
tracepath -n example.com
mtr -rw -c 20 example.com
Separa dos preguntas: qué MTU observa el camino y cómo responden las sondas repetidas a lo largo del tiempo.
Cheat sheet de comandos y preguntas frecuentes #
# --- TRACEROUTE ---
traceroute -n example.com              # Sin DNS inverso
traceroute -4 example.com              # IPv4
traceroute -6 example.com              # IPv6
traceroute -I example.com              # ICMP Echo
traceroute -T -p 443 example.com       # TCP SYN hacia 443
traceroute -m 15 example.com           # Máximo 15 saltos
traceroute -q 1 example.com            # 1 sonda por salto
traceroute -N 1 example.com            # 1 sonda simultánea
traceroute -w 5 example.com            # Timeout máximo 5 s
traceroute --mtu example.com           # Intentar descubrir MTU

# --- TRACEPATH ---
tracepath -n example.com               # Ruta + PMTU, sin DNS
tracepath -l 1480 example.com          # Longitud inicial elegida por ti

# --- IP ROUTE ---
ip route                               # Tabla de rutas
ip route show default                  # Gateway por defecto
ip route get 8.8.8.8                   # Resolución de ruta del kernel

# --- MTR ---
mtr -rw -c 20 example.com              # Informe de 20 ciclos
Preguntas frecuentes
¿Para qué sirve Traceroute?
Para inferir qué respondedores aparecen a distancias sucesivas desde tu origen y ayudar a diagnosticar routing, filtrado o cambios de camino. No es un mapa físico de Internet.
¿Qué significa un salto?
Es la respuesta asociada a una sonda con cierto TTL/Hop Limit. Normalmente procede de una interfaz de un sistema que procesó la expiración, pero una línea no equivale necesariamente a un único equipo físico.
¿Qué significan * * *?
Que no se recibió una respuesta utilizable antes del timeout para esas sondas. Puede haber filtrado, rate limiting, pérdida, asimetría o simplemente un dispositivo que no responde.
¿Por qué aparecen tres tiempos?
Traceroute for Linux envía tres sondas por valor de TTL de forma predeterminada. Puedes cambiarlo con -q.
¿El RTT de un salto mide la latencia entre ese router y el anterior?
No. Es el tiempo de ida y vuelta entre tu origen y quien respondió a esa sonda, incluyendo el camino de retorno.
¿Qué diferencia hay entre Ping y Traceroute?
Ping observa principalmente alcanzabilidad y RTT hacia un destino. Traceroute varía TTL/Hop Limit para provocar respuestas a distintas distancias del camino.
¿Qué diferencia hay entre Traceroute y Tracepath?
Tracepath usa UDP, tiene un enfoque sencillo y descubre PMTU sin requerir superusuario. Traceroute ofrece más métodos y opciones, incluido --mtu.
¿Tracepath necesita root?
No. La documentación actual de iputils lo define como herramienta no privilegiada.
¿Qué es la PMTU?
Es el tamaño máximo de paquete que puede atravesar el camino sin superar la MTU de ninguno de sus enlaces.
¿Debo seguir usando route?
route sigue existiendo en net-tools, pero su propia documentación indica que está en gran medida sustituido por ip route.
¿Traceroute usa siempre ICMP?
No. Traceroute for Linux usa UDP tradicional por defecto y permite, entre otros, ICMP con -I y TCP SYN con -T.
¿Por qué Linux traceroute y Windows tracert pueden mostrar salidas distintas?
Porque usan sondas predeterminadas distintas y la red puede aplicar políticas o balanceo diferentes según protocolo, puertos y flujo.
¿Qué es mejor: Traceroute o MTR?
Depende de la pregunta. Traceroute es una instantánea; MTR repite sondas y muestra estadísticas. Ninguno convierte por sí solo la respuesta de un router intermedio en prueba de pérdida del tráfico de usuario.
¿Una traza detenida demuestra que ese router está caído?
No. Puede ser el último equipo que responde antes de un filtro, un cambio de política o un tramo silencioso. Correlaciona con el destino, otros métodos y otras fuentes de telemetría.
¿Cómo cambia en IPv6?
IPv6 utiliza Hop Limit en lugar del campo TTL de IPv4. La idea de incrementar el límite de saltos para provocar ICMPv6 Time Exceeded es equivalente a nivel de diagnóstico.