Respuesta rápida: ¿qué es un registro en programación? #
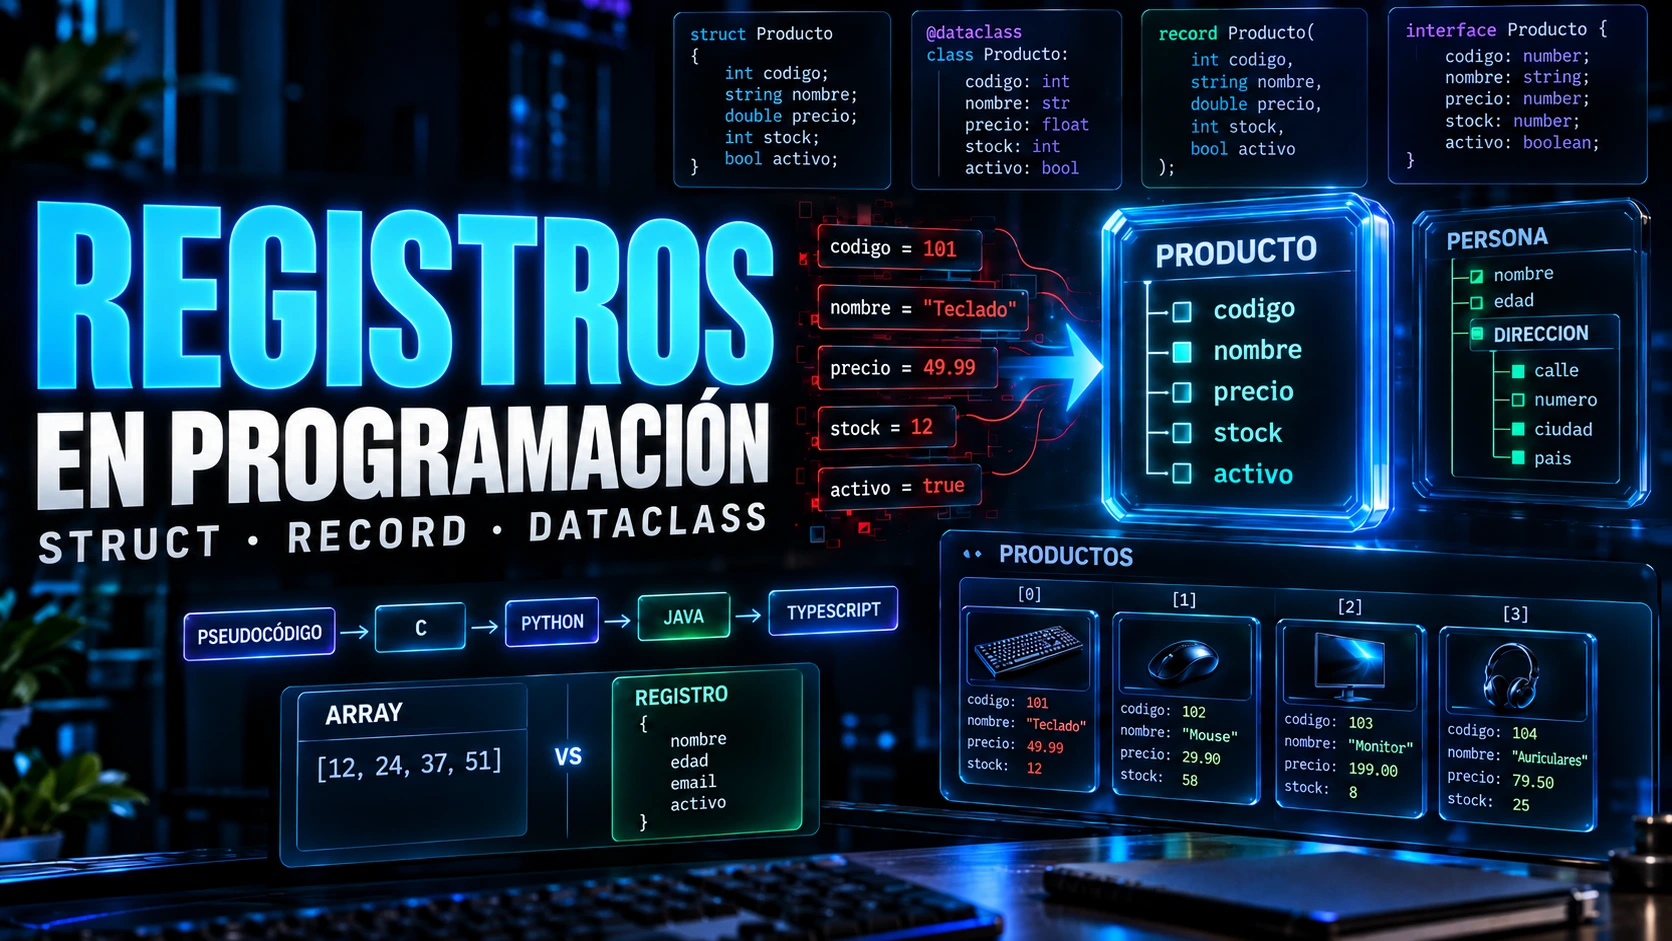
Un registro es una forma de agrupar varios datos relacionados bajo una misma entidad mediante campos con nombre. En pseudocódigo suele llamarse REGISTRO; en lenguajes reales el concepto aparece con construcciones diferentes como struct, record, clases de datos o tipos de objeto.
Empleado
├── legajo: entero
├── nombre: texto
├── salario: decimal
└── activo: booleano
La idea importante no es memorizar una palabra reservada, sino reconocer el patrón: varios atributos describen una misma entidad. La sintaxis y, sobre todo, la semántica cambian según el lenguaje. Por ejemplo, una struct de C, un record de Java y una interface de TypeScript no son equivalentes en memoria, mutabilidad, igualdad ni comportamiento.
El manual oficial de GNU C describe una estructura como un tipo definido por el usuario compuesto por campos con nombre y tipo. Ese es un buen punto de partida conceptual, sin convertir struct y record en sinónimos universales.
Por qué existen los registros: de variables sueltas a entidades #
Supón que quieres representar un producto. Necesitas un código, un nombre, un precio, una cantidad disponible y un estado. Mantener esos valores como variables independientes funciona en ejemplos pequeños, pero dificulta expresar que todos pertenecen al mismo concepto.
Producto
├── codigo: 101
├── nombre: "Teclado"
├── precio: 49.99
├── stock: 12
└── activo: verdadero
Agrupar los campos aporta cohesión semántica: las funciones pueden recibir un producto, las colecciones pueden almacenar productos y el modelo del programa se parece más al dominio que intenta resolver. No significa que todo deba modelarse como registro; significa que los datos que cambian y se usan como una unidad suelen beneficiarse de una representación conjunta.
Registro vs. variable simple: el salto conceptual #
Una variable escalar suele representar un único valor:
edad = 28Un registro representa una unidad compuesta:
persona
├── nombre = "Ana"
├── edad = 28
├── altura = 1.68
└── activo = verdadero
El salto conceptual consiste en pasar de “tengo valores sueltos” a “tengo una entidad con propiedades”. Ese cambio ayuda tanto en programación estructurada como en orientación a objetos, serialización, APIs y procesamiento de eventos.
Registro vs. array: heterogeneidad y significado propio #
En pseudocódigo y en muchos lenguajes con arrays tipados, un array expresa una colección indexada de elementos del mismo tipo declarado, mientras que un registro expresa campos con nombre que pueden tener tipos distintos. En lenguajes dinámicos existen listas/arrays que admiten valores heterogéneos, por lo que esta distinción debe entenderse como una comparación de propósito, no como una ley universal.
| Criterio | Array / lista | Registro / struct / record |
|---|---|---|
| Identidad de cada dato | Normalmente por posición o índice. | Por nombre de campo/componente. |
| Uso típico | Secuencia o colección de elementos. | Atributos de una entidad. |
| Tipos | Depende del lenguaje; a menudo un tipo de elemento declarado. | Los campos pueden declarar tipos distintos. |
| Acceso | productos[0] | producto.precio en lenguajes con acceso por punto. |
Los campos y sus tipos: la riqueza de datos heterogéneos #
Al definir un registro eliges qué campos forman parte del modelo y qué tipo representa mejor a cada uno:
REGISTRO Producto
    codigo: ENTERO
    nombre: CADENA
    precio: DECIMAL
    stock: ENTERO
    disponible: BOOLEANO
FIN_REGISTRO
La ventaja no es solo almacenar valores heterogéneos. También haces explícito el contrato de datos: qué información existe, cómo se llama y qué espera el resto del programa. El tipo exacto —por ejemplo, cómo representar dinero— depende del lenguaje y de los requisitos de precisión.
Tipo vs. instancia: el plano arquitectónico frente al objeto real #
Conviene separar dos conceptos:
- Tipo o definición: describe qué campos tendrá una entidad y qué reglas impone el lenguaje.
- Instancia: es un valor concreto que cumple esa definición.
Tipo: Producto
│
├── producto1 = { codigo: 101, nombre: "Teclado", precio: 49.99, stock: 12 }
└── producto2 = { codigo: 102, nombre: "Ratón",   precio: 24.99, stock: 7 }
En una explicación inicial puedes pensar en la definición como el “molde” y en cada instancia como un caso concreto. La representación real en memoria depende del lenguaje, compilador/runtime y contexto de ejecución.
Cómo acceder a los campos: el operador punto (.) #
Muchos lenguajes usan el operador punto para acceder a un campo, propiedad o componente:
producto.nombre
producto.precio
Pero no es una regla universal. C, por ejemplo, diferencia . para una estructura y -> cuando accedes a través de un puntero. Java records exponen métodos accessors como producto.nombre(). Lo importante es distinguir el nombre lógico del campo de la sintaxis concreta del lenguaje.
Ejemplo completo en pseudocódigo y ventajas de legibilidad #
ALGORITMO GestionInventario
    REGISTRO Producto
        codigo: ENTERO
        nombre: CADENA
        precio: REAL
        stock: ENTERO
    FIN_REGISTRO

    DEFINIR producto1 COMO Producto
    producto1.codigo = 101
    producto1.nombre = "Teclado Mecánico"
    producto1.precio = 49.99
    producto1.stock = 12

    ESCRIBIR producto1.nombre
    ESCRIBIR producto1.precio * producto1.stock
FIN_ALGORITMO
El ejemplo concentra los atributos relacionados y permite pasar la entidad completa a funciones sin inventar nombres paralelos para cada propiedad. Si todavía estás aprendiendo a modelar datos, este es un buen momento para practicar primero la lógica y el diseño antes de preocuparte por detalles específicos de un lenguaje.
Fundamentos y lógicaDesarrolla la Lógica de Programación con PSeInt y algoritmosPractica variables, arrays, registros, funciones y algoritmos desde una base estructurada.Array de registros: combinando colecciones con entidades #
Cuando necesitas una colección de entidades, combinas ambos conceptos: una colección contiene múltiples registros del mismo modelo lógico.
productos
├── [0] → { codigo: 101, nombre: "Teclado", precio: 49.99, stock: 12 }
├── [1] → { codigo: 102, nombre: "Ratón",   precio: 24.99, stock: 7 }
└── [2] → { codigo: 103, nombre: "Monitor", precio: 199.99, stock: 4 }
El acceso combina índice y campo:
productos[0].nombre
productos[1].precio
En lenguajes concretos la colección podría ser un array, lista, vector, slice u otra estructura; el patrón conceptual es el mismo.
Recorrer, buscar y ordenar en arrays de registros #
PARA i = 0 HASTA cantidad - 1
    ESCRIBIR productos[i].codigo, productos[i].nombre
FIN_PARAbuscarCodigo = 102
PARA i = 0 HASTA cantidad - 1
SI productos[i].codigo == buscarCodigo ENTONCES
ESCRIBIR productos[i].nombre
FIN_SI
FIN_PARAUn algoritmo o función de ordenación puede comparar precio, nombre u otro campo. Cuando reordenas una colección de entidades, debes conservar cada entidad completa; no ordenar por separado arrays paralelos que puedan desincronizarse.
Registros anidados: modelando jerarquías y relaciones complejas #
Un campo puede contener otra estructura compuesta. Esto permite expresar relaciones de composición:
REGISTRO Direccion
    calle: CADENA
    numero: ENTERO
    ciudad: CADENA
    codigoPostal: CADENA
FIN_REGISTRO

REGISTRO Cliente
    id: ENTERO
    nombre: CADENA
    domicilio: Direccion
FIN_REGISTRO
En una sintaxis con acceso por punto podrías consultar cliente1.domicilio.ciudad. La composición es útil cuando una parte tiene significado propio y puede reutilizarse en otros modelos.
Registros que contienen arrays y arrays de registros anidados #
También puedes tener colecciones dentro de una entidad:
REGISTRO Alumno
    nombre: CADENA
    calificaciones: ARRAY[4] DE REAL
FIN_REGISTRO
Y una colección de alumnos puede producir rutas como alumnos[2].calificaciones[0]. La lectura se hace por capas: colección exterior → entidad → campo → elemento interior.
Registros en C: la clásica `struct` y semántica de valor en memoria #
En C, struct define un tipo compuesto con campos nombrados:
#include <stdio.h>

typedef struct {
    int codigo;
    char nombre[50];
    double precio;
    int stock;
} Producto;

int main(void) {
    Producto p1 = {101, "Teclado", 49.99, 12};
    Producto p2 = p1;       // asignación de la estructura por valor
    p2.stock = 99;

    printf("%d %d\n", p1.stock, p2.stock);
}
La asignación entre estructuras compatibles copia el valor de la estructura. Eso no convierte cualquier dato apuntado por sus campos en una copia profunda: si un campo es un puntero, se copia el valor del puntero.
Registros en Python: `@dataclass`, anotaciones y mutabilidad #
Python ofrece @dataclass desde Python 3.7 para generar automáticamente comportamiento habitual de clases centradas en datos:
from dataclasses import dataclass

@dataclass
class Producto:
    codigo: int
    nombre: str
    precio: float
    stock: int

prod = Producto(101, "Teclado", 49.99, 12)
print(prod.nombre)
print(prod)
Con la configuración por defecto se generan, entre otros, __init__(), __repr__() y __eq__(). Las anotaciones de tipo ayudan a herramientas y analizadores, pero @dataclass no valida automáticamente esos tipos en runtime.
frozen=True: la documentación oficial de Python dice expresamente que no es posible crear objetos Python verdaderamente inmutables mediante esta opción; frozen=True emula instancias de solo lectura bloqueando asignaciones normales a campos. Si un campo referencia un objeto mutable, ese objeto puede seguir cambiando.Registros en Java moderno: `record` e inmutabilidad superficial #
Los record de Java son una forma concisa de declarar clases que transportan un conjunto fijo de valores:
public record Producto(int codigo, String nombre, double precio, int stock) {}

Producto p = new Producto(101, "Teclado", 49.99, 12);
System.out.println(p.nombre());
Los records fueron una característica preview en Java 14 y 15 y quedaron finalizados en Java 16. El compilador proporciona constructor canónico, campos privados final, accessors y métodos como equals(), hashCode() y toString().
A fecha de esta revisión, JDK 27 es la versión más reciente y JDK 25 es la LTS vigente. Para separar semántica de records de instalación/versiones, consulta la guía actual de versiones de Java; si vas a programar en Linux, sigue el tutorial de instalación y configuración del JDK en Linux.
Registros en TypeScript: interfaces y forma (shape) en el sistema de tipos #
En TypeScript, una interface puede describir la forma esperada de un objeto:
interface Producto {
    codigo: number;
    nombre: string;
    precio: number;
    stock: number;
}

const teclado: Producto = {
    codigo: 101,
    nombre: "Teclado",
    precio: 49.99,
    stock: 12
};
TypeScript usa tipado estructural: importa que el valor tenga la forma exigida por el tipo. Pero las interfaces son información de tipos para el compilador y se eliminan al generar JavaScript. La documentación oficial deja claro que el sistema de tipos no cambia el comportamiento del programa en ejecución.
interface no valida una respuesta JSON recibida de Internet. Para datos externos necesitas validación runtime adicional si la confianza en el esquema es importante.Registros en C#: `struct`, `record class` y `record struct` #
C# separa dos decisiones: si el tipo tiene semántica de valor o referencia y si quieres el comportamiento generado de un record.
struct: tipo de valor. Al asignarlo a otra variable se copia el valor de la instancia. No significa “siempre almacenado en la pila”; la ubicación depende del contexto y, por ejemplo, un valor boxed vive en el heap administrado.record class/record: tipo de referencia con igualdad por valor generada y soporte para expresioneswith.record struct: tipo de valor con comportamiento de record. En forma posicional es mutable por defecto; usareadonly record structcuando necesitas propiedades posicionales de solo inicialización.
Microsoft documenta estas diferencias en la guía oficial de records de C#. Evita elegir struct solo por una supuesta ventaja automática de memoria o rendimiento: el contexto de copia, boxing, tamaño y uso real importa.
Tabla comparativa: el mismo concepto en distintos lenguajes #
| Lenguaje / construcción | Qué representa | Mutabilidad / igualdad relevante |
|---|---|---|
Pseudocódigo REGISTRO | Modelo pedagógico de campos nombrados. | Depende del pseudolenguaje o implementación. |
C struct | Tipo compuesto con campos nombrados. | Asignación por valor de la estructura; layout dependiente de plataforma. |
Python @dataclass | Clase con métodos generados a partir de campos. | Mutable por defecto; frozen=True emula solo lectura. |
Java record | Clase final para un agregado fijo de componentes. | Inmutabilidad superficial de componentes; igualdad generada. |
TypeScript interface | Contrato estático de forma. | No existe como validador en runtime; mutabilidad depende de propiedades/JS. |
C# record class | Record de tipo referencia. | Igualdad por valor generada; propiedades posicionales init-only. |
C# record struct | Record de tipo valor. | Copia por valor; posicional mutable salvo readonly. |
La tabla compara el rol conceptual, no afirma equivalencia de implementación. Si el diseño depende de identidad, hashing, layout, serialización, herencia o thread-safety, consulta la especificación/documentación del lenguaje concreto.
Registro vs. diccionario, tupla, clase y objeto JSON #
Un mapa es útil cuando las claves son dinámicas o el esquema no está fijado de antemano. Un tipo con campos declarados aporta nombres y estructura conocida, pero no es automáticamente mejor: depende de si el dominio necesita un esquema estable.
Una tupla funciona bien cuando la posición tiene significado claro o el lenguaje permite elementos nombrados. Si la legibilidad depende de recordar posiciones, un tipo con nombres de campo puede comunicar mejor la intención. No existe un número universal de elementos a partir del cual una tupla “deje de ser válida”.
No son categorías excluyentes. En Java un record es una clase restringida; en Python una dataclass también es una clase. Los records pueden incluir métodos e invariantes. La decisión depende de identidad, mutabilidad, herencia, encapsulación y comportamiento, no de una regla “datos = record, lógica = clase”.
JSON es un formato de datos serializado. Un objeto JSON no impone por sí solo el tipo estático, la identidad ni la semántica de igualdad de la estructura que usas dentro del programa.
Del registro en memoria a APIs JSON y bases de datos relacionales #
Los mismos campos pueden aparecer en varias capas, pero cada capa tiene reglas distintas:
JSON recibido/enviado
        ⇅ serialización / validación
Objeto o registro en memoria
        ⇅ mapeo explícito / ORM
Fila o documento persistido
No existe una equivalencia automática 1:1. Un API puede renombrar campos, omitir propiedades, convertir fechas o números; una base de datos puede normalizar información en varias tablas; y un ORM puede aplicar transformaciones adicionales. Pensar en registros ayuda a comprender el flujo, pero serialización, esquema y persistencia son problemas separados.
Caso práctico completo: sistema de gestión escolar #
Un ejemplo completo en pseudocódigo:
REGISTRO Alumno
    id: ENTERO
    nombre: CADENA
    email: CADENA
    calificaciones: ARRAY[3] DE REAL
    activo: BOOLEANO
FIN_REGISTRO

FUNCION REAL calcularPromedio(Alumno est)
    suma = 0.0
    PARA i = 0 HASTA 2
        suma = suma + est.calificaciones[i]
    FIN_PARA
    RETORNAR suma / 3.0
FIN_FUNCION

ALGORITMO EvaluacionCurso
    DEFINIR a1 COMO Alumno
    a1.id = 504
    a1.nombre = "Marcos Soler"
    a1.email = "marcos@instituto.edu"
    a1.calificaciones[0] = 8.5
    a1.calificaciones[1] = 9.0
    a1.calificaciones[2] = 7.5
    a1.activo = VERDADERO

    ESCRIBIR calcularPromedio(a1)
FIN_ALGORITMO
La función recibe una entidad completa. En un lenguaje real también decidirías validación, errores, privacidad, persistencia y qué campos deberían ser opcionales.
7 Errores frecuentes al modelar datos y cómo evitarlos #
Separar nombres[], edades[] y emails[] exige mantener los mismos índices durante todas las operaciones. Una colección de entidades reduce ese riesgo cuando los datos pertenecen al mismo concepto.
Un tipo debería tener un propósito claro. Si agrupa datos que no cambian ni se usan juntos, probablemente estás escondiendo varios conceptos distintos.
No existe un número universal de campos “correcto”. Evalúa cohesión, cambios frecuentes, reutilización, responsabilidades y coste de serialización.
Guardar simultáneamente el dato base y uno calculable puede generar inconsistencias. A veces sí conviene persistir snapshots históricos o valores precalculados; documenta la fuente de verdad.
Usa tipos apropiados cuando el lenguaje y dominio los ofrezcan. Para dinero, fechas o identificadores, la elección debe considerar precisión y reglas del negocio; un float no es una recomendación universal para importes monetarios.
Una variable desaparece al terminar el proceso salvo que sus datos se persistan. Archivo, base de datos y servicio remoto tienen reglas propias.
Primero identifica operaciones, límites y datos necesarios. Después define la estructura mínima que mantiene el modelo comprensible.
Estructuras y registros aplicados a la ciberseguridad #
En ciberseguridad abundan datos estructurados: eventos, alertas, hallazgos, activos, vulnerabilidades e indicadores. Puedes representarlos como objetos con campos, por ejemplo:
AlertaSeguridad
├── id: 10482
├── timestamp: "2026-09-19T08:45:12Z"
├── ipOrigen: "192.0.2.10"
├── ipDestino: "203.0.113.50"
├── puertoDestino: 443
├── regla: "OUTBOUND_ANOMALOUS_TRAFFIC"
├── severidad: "alta"
└── estado: "abierta"
La estructura concreta dependerá del producto, schema y pipeline. Un hallazgo no tiene por qué incluir siempre CVE o CVSS, y un evento SIEM no comparte necesariamente el mismo esquema que otro proveedor. La habilidad transferible es saber leer, transformar, filtrar y validar datos estructurados.
Si quieres conectar esta base con seguridad defensiva u ofensiva, la guía sobre qué programación necesitas realmente para ciberseguridad explica cuándo el código aporta valor y cuándo no es un requisito central.
7 Ejercicios prácticos graduados para consolidar tu aprendizaje #
- Ficha de libro: define ISBN, título, autor, año y precio. Instancia tres libros y obtén el más antiguo.
- Inventario: crea una colección de productos y calcula el valor de inventario con
precio × stock. - Notas: modela un alumno con cuatro calificaciones y calcula su promedio.
- Empleados: calcula una media salarial usando un tipo numérico adecuado al lenguaje elegido.
- Composición: separa
ClienteyDirecciony accede a campos anidados. - Búsqueda: localiza un producto por código y representa claramente el caso “no encontrado”.
- Conversión multilenguaje: implementa el mismo
Productoen pseudocódigo, C, Python y Java y anota qué cambia en mutabilidad, igualdad y acceso.
El objetivo no es memorizar cuatro sintaxis: es reconocer qué propiedades pertenecen al concepto y qué garantías ofrece cada lenguaje.
Preguntas frecuentes sobre registros en programación #
Es un modelo de datos compuesto por campos con nombre que representan atributos relacionados. El término es conceptual; cada lenguaje ofrece construcciones y garantías diferentes.
Un array/lista representa una colección indexada de elementos; un registro representa atributos nombrados de una entidad. Los detalles de tipos y mutabilidad dependen del lenguaje.
struct en C?Un tipo compuesto definido por el usuario. Sus campos tienen nombre y tipo, y su layout puede incluir padding dependiente de la plataforma.
@dataclass de Python valida tipos?No por sí sola. Usa anotaciones para definir campos y generar métodos, pero las anotaciones no se convierten automáticamente en validación runtime.
record de Java es inmutable?Es superficialmente inmutable: sus componentes no pueden reasignarse, pero los objetos mutables referenciados por esos componentes pueden cambiar.
No. Las interfaces se eliminan al compilar a JavaScript; necesitas validación runtime separada para datos externos.
Conclusión: los nombres cambian, el principio arquitectónico permanece #
REGISTRO, struct, @dataclass, record e interface pueden ayudarte a expresar la misma idea general —datos relacionados con nombres significativos—, pero no ofrecen las mismas garantías.
Para razonar bien sobre una estructura compuesta, haz cuatro preguntas: ¿cómo se construye?, ¿es mutable?, ¿qué significa igualdad? y ¿cómo se representa/valida en runtime? Con esas preguntas puedes trasladar el concepto entre lenguajes sin confundir sintaxis con semántica.
El siguiente paso depende de tu objetivo. Para mantenerte dentro de Java, revisa la guía actual de versiones de Java y el tutorial de Java en Linux. Si tu objetivo es seguridad, deriva a programación para ciberseguridad en lugar de convertir este artículo en un roadmap de carrera.