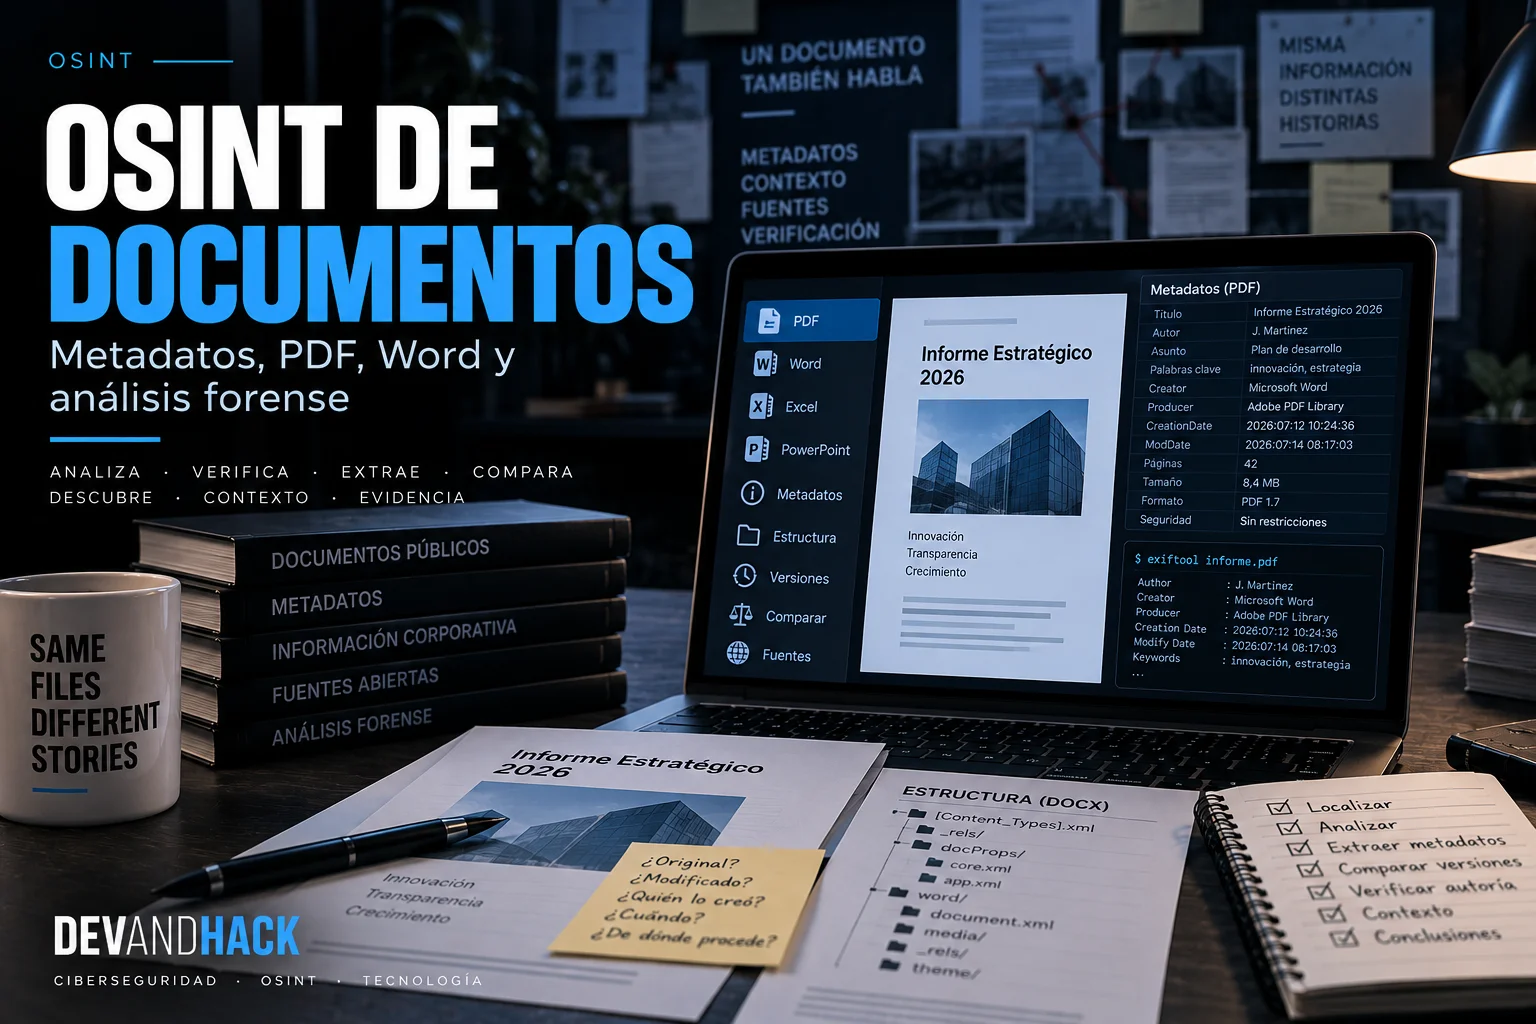
Respuesta rápida: ¿qué es el OSINT de documentos? #
El OSINT de documentos consiste en localizar, analizar, verificar, auditar y relacionar documentos técnicos, corporativos o institucionales accesibles mediante fuentes abiertas (como archivos PDF, DOCX, XLSX, PPTX, CSV o formatos ofimáticos históricos).
El objetivo analítico nunca se reduce a una simple extracción automática de propiedades técnicas. Un investigador profesional de fuentes abiertas busca evidencias documentales y técnicas contrastables para responder preguntas críticas:
- 01Procedencia y autoría formal: ¿Quién figura como autor declarado en el texto frente al usuario o entidad que el archivo registra internamente en sus metadatos?
- 02Entorno y flujo de publicación: ¿Qué organización lo publicó, a través de qué dominio o URL oficial se distribuyó y en qué fecha apareció públicamente indexado?
- 03Historia técnica y software: ¿Con qué aplicación ofimática se redactó y qué software o biblioteca técnica produjo la conversión final a PDF?
- 04Trazabilidad de versiones: ¿Existen borradores o versiones anteriores en archivos históricos y coincide el documento actual con el original publicado?
- 05Coherencia factual: ¿Es compatible el contenido interno con el marco temporal y contexto declarados en la portada del informe?
En definitiva: en OSINT documental no buscamos campos aislados por mera curiosidad técnica; buscamos un cuerpo coherente de evidencias para resolver una pregunta analítica.
1. Empieza por una pregunta, no por ExifTool #
Imagina que recibes un archivo en formato PDF denominado Informe_Final_2026.pdf. La reacción inmediata de muchos analistas noveles consiste en lanzar de inmediato una herramienta en la terminal como ExifTool para volcar en pantalla cientos de líneas de metadatos brutos. Sin embargo, en el análisis profesional de fuentes abiertas, ese paso nunca debe ser el primero.
Antes de abrir cualquier herramienta forense, formula con precisión tu objetivo: ¿Qué necesito demostrar exactamente sobre este archivo? ¿Buscas verificar si este informe procede auténticamente de la entidad que aparece en el membrete? ¿Quieres averiguar si fue redactado antes de una fecha crítica? ¿O necesitas confirmar si el archivo ha sido alterado por un tercero tras su difusión inicial?
Definir la pregunta transforma de raíz el curso de la investigación. Ya no nos limitamos a contemplar pasivamente una lista de etiquetas técnicas; ahora investigamos la URL original de descarga, el dominio emisor, los certificados digitales, la identidad de los autores, las referencias normativas cruzadas y la hemeroteca pública. Como suelo recalcar a mis alumnos: si comienzas preguntando «¿Qué metadatos tiene este archivo?» obtendrás información; si empiezas preguntando «¿Qué necesito demostrar objetivamente?» construirás auténtica inteligencia.
2. El primer metadato es la URL #
Antes de descargar o inspeccionar los bytes internos de un documento, observa detenidamente de qué entorno web procede. La dirección URL es, en sí misma, el primer y más determinante metadato contextual del archivo.
Una dirección web estructurada como https://example.org/informes/gobierno-corporativo/2026/informe-2026.pdf aporta una cantidad ingente de contexto probado: documenta el nombre del dominio institucional, la estructura jerárquica de directorios del servidor, la taxonomía interna de la organización y la página web concreta que enlaza al recurso. Compara ese caudal de información verificable con recibir un archivo descontextualizado llamado informe.pdf reenviado por un canal de mensajería instantánea. El contenido en texto puede ser idéntico, pero el valor probatorio es abismalmente diferente.
Siempre que sea posible, preserva documentalmente la cadena completa de adquisición. El documento aislado es solo una pieza; la ruta que condujo hasta él es la prueba de su procedencia.
3. Preserva el archivo antes de analizarlo #
Si el documento posee relevancia para un caso forense, un peritaje judicial o un informe corporativo de ciberseguridad, jamás trabajes directamente sobre el archivo original descargado. Los visores ofimáticos, editores de PDF y herramientas de análisis pueden actualizar marcas temporales de acceso o modificar bloques internos sin que te percates.
Conserva intacto el archivo original en una carpeta de evidencias segura y calcula de forma inmediata su huella criptográfica SHA-256 desde la línea de comandos:
# En entornos Linux y macOS:
sha256sum informe.pdf

# En entornos Windows con PowerShell:
Get-FileHash ./informe.pdf -Algorithm SHA256
Es vital comprender el alcance probatorio de este paso: el cálculo de un hash criptográfico no demuestra que el contenido del documento sea veraz ni acredita la autoría del firmante. Demuestra con certeza matemática absoluta la integridad del fichero: certifica que la copia sobre la que vas a trabajar y presentar tus hallazgos contiene exactamente los mismos bytes que el archivo tal como fue capturado en la fecha y hora registradas.
4. Nombre del archivo: pista útil, prueba débil #
Un nombre de archivo como Presupuesto_CLIENTE_FINAL_v7_JMendoza.xlsx puede parecer enormemente revelador a primera vista. Sugiere el nombre de un cliente corporativo, un número correlativo de versión, las iniciales de un responsable (J. Mendoza) y una descripción funcional del proyecto.
Sin embargo, en el análisis forense y de fuentes abiertas rige una máxima inmutable: el nombre de un archivo es una excelente pista analítica, pero una prueba probatoria sumamente débil. Cualquier usuario puede renombrar un fichero en una fracción de segundo sin dejar rastro en el sistema de archivos del destinatario. Por tanto, utiliza las pistas del nombre para formular hipótesis de búsqueda, pero jamás afirmes una conclusión pericial basándote únicamente en cómo se llama el archivo.
5. Localizar documentos mediante Google #
Para localizar documentación corporativa, manuales técnicos o memorias institucionales que no están enlazadas en los menús públicos principales, los operadores avanzados de búsqueda que estudiamos en nuestra guía de Google Dorks resultan letales.
Google soporta de forma estándar el operador filetype: (o su equivalente ext:) para acotar resultados a formatos documentales específicos:
# Búsqueda de documentos PDF en un dominio corporativo:
site:example.com filetype:pdf

# Búsqueda de hojas de cálculo o informes financieros con frases exactas:
site:example.com filetype:xlsx "balance de situacion"

# Localización de documentos publicados antes de una fecha concreta:
site:example.com filetype:pdf before:2024-01-01 "auditoria interna"

# Búsqueda cruzada de formatos Office modernos:
site:example.com (filetype:docx OR filetype:pptx) "confidencial"
Recuerda que encontrar un documento mediante un dork no certifica que el archivo siga vigente o represente la postura oficial actual de la organización; demuestra documentalmente que dicho archivo estuvo o está indexado en sus servidores públicos.
6. Buscar el título exacto puede encontrar copias #
Cuando tienes en tus manos un documento cuya procedencia resulta dudosa o incompleta, una de las técnicas de correlación más sencillas y eficaces es seleccionar su título completo o una frase formal del encabezado y buscarla entrecomillada en buscadores web:
"Informe sobre Transformacion Digital del Sector Publico 2025"Esta consulta textual exacta suele destapar rápidamente copias alternativas en repositorios universitarios, publicaciones de proveedores tecnológicos involucrados, notas de prensa oficiales, borradores en portales de transparencia o registros de licitaciones públicas. Al cotejar varias apariciones del mismo título, la investigación trasciende el archivo aislado y permite construir una cronología documental sólida.
7. PDF: empieza por las propiedades visibles #
El formato PDF (Portable Document Format) incorpora desde sus orígenes un diccionario estándar de información del documento (Info Dictionary) que define propiedades clave como el título, autor, asunto, palabras clave, software de creación y fechas de gestión.
Adobe distingue formalmente entre las propiedades básicas del documento y los paquetes estructurados de metadatos más avanzados. Desde cualquier visor como Adobe Acrobat o visores de código abierto podemos inspeccionar estas propiedades mediante los atajos de teclado del menú de propiedades (Ctrl+D), pero desde el punto de vista analítico es mucho más rápido y fiable consultar la consola mediante herramientas especializadas:
# Inspección forense con ExifTool:
exiftool informe.pdf

# Lectura rápida de cabecera con pdfinfo (Poppler utils):
pdfinfo informe.pdf
La salida revelará campos fundamentales como Author, Creator, Producer, CreationDate y ModDate. No obstante, leer estos campos es solo el calentamiento analítico: el reto reside en interpretarlos sin caer en trampas conceptuales.
8. Creator y Producer no significan lo mismo #
Uno de los errores más extendidos en análisis pericial es confundir los campos Creator y Producer en la ficha técnica de un PDF. Conceptualmente describen dos momentos radicalmente diferentes del ciclo de vida digital del archivo:
- Creator (Creador): Identifica la aplicación original en la que se redactó o diseñó el contenido antes de ser transformado a PDF (por ejemplo:
Microsoft Word,Canva,Google DocsoAdobe InDesign). - Producer (Productor): Especifica el motor técnico o biblioteca de software que convirtió ese documento original en la estructura final de objetos PDF (por ejemplo:
Adobe PDF Library,macOS Quartz PDFContext,PDFium,GhostscriptoiText).
Por consiguiente, si un PDF muestra Producer: Adobe PDF Library y Creator: Microsoft Word, sería un gravísimo error afirmar en un informe que el autor «escribió el informe en Adobe Acrobat». Los metadatos tienen un significado técnico preciso: alterarlo por desconocimiento deslegitima las conclusiones de una investigación.
9. CreationDate no demuestra cuándo se escribió el contenido #
Imagina que ExifTool arroja el campo CreationDate: 2026:04:15 10:30:00+02:00. ¿Significa esto que el autor redactó el informe el 15 de abril de 2026? Absolutamente no.
El metadato CreationDate de un PDF refleja únicamente el instante en el que el conversor o la impresora virtual generó esa instancia concreta del fichero PDF. El texto intelectual pudo haber sido redactado semanas o meses antes en un procesador de textos, haber sido extraído de una plantilla antigua creada en 2020 o haber sido compilado automáticamente a partir de una base de datos. La fecha técnica debe ser siempre contrastada con la fecha formal escrita en la portada, las citas bibliográficas internas y las marcas de tiempo de los servidores de publicación.
10. ModDate tampoco demuestra la última edición intelectual #
El mismo razonamiento escéptico debe aplicarse al campo ModDate (fecha de modificación). Un archivo PDF actualiza su marca de modificación por infinidad de procesos automáticos que no alteran un solo párrafo del texto:
- La inserción de un sello o firma digital por parte de una pasarela administrativa.
- La apertura del archivo en un software que optimiza o recomprime fuentes tipográficas al cerrar.
- La actualización de formularios interactivos o marcadores de lectura.
- La exportación del archivo a través de una pasarela web de gestión documental (DMS).
Por tanto, el rigor lingüístico es innegociable: el analista debe certificar que «el campo ModDate registra una modificación técnica en dicha fecha», no atribuir precipitadamente que el autor humano estuviera editando el texto en ese momento.
11. PDF puede contener más de una capa de metadatos (XMP) #
Los archivos PDF modernos no almacenan sus propiedades en un único bloque monolítico. Coexisten habitualmente dos sistemas de metadatos diferenciados:
- El diccionario de información clásico (Document Information Dictionary): Estructura heredada de las primeras especificaciones PDF con pares clave-valor simples.
- Los flujos XMP (Extensible Metadata Platform): Normalizados internacionalmente bajo la familia estándar ISO 16684-1, que incrustan paquetes XML extensibles basados en RDF capaces de documentar historiales de cambios, licencias de derechos de autor y metadatos de múltiples herramientas.
Esta dualidad técnica es sumamente interesante para el analista: en muchas ocasiones, al editar un PDF con programas secundarios, una de las capas se actualiza mientras la otra conserva los valores originales antiguos. Detectar discrepancias entre el diccionario clásico y el paquete XMP no implica necesariamente manipulación maliciosa, pero proporciona pistas forenses de primer nivel sobre el flujo de herramientas que trataron el archivo.
12. ExifTool permite inspeccionar metadatos PDF #
Para extraer y discriminar con precisión quirúrgica cada familia de metadatos en un PDF, la herramienta insustituible es ExifTool. Su potencia radica en su capacidad para desglosar la procedencia exacta de cada etiqueta:
# Muestra etiquetas agrupadas por familia (PDF, XMP, File):
exiftool -G1 -a -s documento.pdf
Los parámetros utilizados son fundamentales en investigación:
-G1: Imprime el nombre del grupo o capa de procedencia (por ejemplo:[PDF]frente a[XMP-dc]o[XMP-xmp]).-a: Fuerza a mostrar todas las etiquetas duplicadas, impidiendo que el software oculte campos con el mismo nombre que contengan valores distintos.-s: Muestra los nombres técnicos reales de las etiquetas en lugar de descripciones traducidas, facilitando la automatización en scripts periciales.
13. Una herramienta de metadatos no demuestra autoría #
Supongamos que ejecutas ExifTool y lees nítidamente: Author: Maria Gonzalez. Concluir en tu informe que «María González escribió este informe» es una negligencia metodológica grave.
Ese campo puede reflejar múltiples escenarios técnicos completamente ajenos a la redacción del texto: María González pudo haber configurado la plantilla corporativa hace tres años; el equipo informático pudo haber clonado el perfil de usuario de María en varios equipos de la oficina; el redactor real pudo haber utilizado una máquina compartida; o el autor verdadero pudo haber tomado un archivo previo como base y sobreescribir el texto sin limpiar las propiedades del documento.
La redacción analítica profesional debe ser taxativa: «El metadato Author del fichero contiene el valor 'Maria Gonzalez'». Para demostrar autoría intelectual se requiere una cadena de corroboración independiente: correos corporativos, firmas criptográficas, testimonios o acreditaciones públicas en la fuente primaria.
14. Los documentos Office modernos también contienen metadatos #
Aunque el formato PDF acapara la mayor parte de la atención pública por ser el estándar de publicación de informes terminados, los archivos generados por la suite ofimática de Microsoft (Word, Excel y PowerPoint) albergan un volumen de metadatos internos extraordinariamente rico y frecuentemente descuidado por sus creadores.
Microsoft estructura las propiedades de sus documentos en varias categorías formales: propiedades estándar (como título, autor, asunto y palabras clave), propiedades personalizadas definidas por administradores de sistemas y propiedades automáticas que la aplicación actualiza sin intervención del usuario (como el tiempo total de edición, el número de revisiones, la última persona que guardó el fichero o el número exacto de palabras y párrafos). Por esta razón, analizar un archivo .docx original suele ser mucho más revelador que inspeccionar el PDF resultante.
15. DOCX, XLSX y PPTX no son cajas negras (OOXML y ZIP) #
Uno de los conceptos más liberadores para cualquier investigador que se inicia en el análisis forense documental es comprender la verdadera naturaleza física de los formatos modernos de Office. Desde la adopción del estándar internacional Office Open XML (OOXML / ISO/IEC 29500), los archivos con extensiones terminadas en «x» (DOCX, XLSX, PPTX) no son bloques binarios opacos ni cajas negras inaccesibles.
En realidad, un archivo .docx es un contenedor comprimido en formato ZIP estándar que empaqueta decenas de archivos XML jerárquicos, esquemas de relaciones, hojas de estilos e imágenes incrustadas. Puedes comprobarlo de forma inmediata cambiando la extensión del archivo a .zip o listando su contenido desde la consola:
# Listar la estructura interna de un documento Word sin descomprimirlo:
unzip -l informe.docx
La salida desvelará la arquitectura interna del documento:
docProps/core.xml: Propiedades estándar de metadatos (autor, fechas, revisiones).docProps/app.xml: Información sobre el software emisor y estadísticas de edición.word/document.xml: El texto principal del documento estructurado en etiquetas XML.word/media/: Todas las imágenes, logotipos y gráficos vectoriales incrustados en su resolución original.word/_rels/: Las tablas de relaciones que vinculan hipervínculos externos, plantillas y fuentes.
16. `core.xml`: una de las primeras piezas que revisaría #
Dentro del paquete descomprimido de un documento de Office, el archivo docProps/core.xml constituye la piedra angular de la auditoría inicial de metadatos. Basado en el estándar Dublin Core, este fichero XML almacena las propiedades esenciales de autoría y temporalidad:
<dc:creator>: El nombre del usuario o perfil configurado en la aplicación cuando se creó el documento.<cp:lastModifiedBy>: El último usuario que realizó una modificación y guardó el archivo.<dcterms:created>: La marca de tiempo precisa (en formato UTC) en la que se generó la estructura del archivo.<dcterms:modified>: El momento exacto de la última modificación guardada.<cp:revision>: El número acumulado de veces que el documento ha sido guardado.
Imagina un escenario habitual en investigaciones corporativas: una empresa pública presenta un pliego de condiciones técnicas supuestamente redactado por sus propios ingenieros, pero en core.xml el campo dc:creator contiene el nombre de un directivo de una consultora externa que posteriormente resulta adjudicataria del contrato. El metadato no demuestra por sí solo un delito, pero genera una línea de investigación corporativa incontestable.
17. `app.xml`: información sobre la aplicación #
Otro fichero de enorme utilidad dentro del contenedor es docProps/app.xml. Este bloque almacena metadatos extendidos sobre la herramienta técnica utilizada para procesar el documento:
<Application>: Identifica si el documento fue generado por Microsoft Office Word, LibreOffice Writer, Google Docs, WPS Office o bibliotecas automatizadas (como python-docx o Apache POI).<AppVersion>: Refleja la versión numérica exacta del motor ofimático, lo que permite inferir si el autor trabajaba con una versión obsoleta o con parches recientes.<TotalTime>: Registra los minutos totales que el archivo permaneció abierto en modo de edición interactiva.
Estos indicadores técnicos son cruciales para comparar lotes de documentos. Si una organización afirma que dos informes fueron elaborados de forma independiente por comités distintos en sedes separadas, pero ambos comparten idéntica versión interna de software y la misma plantilla base en app.xml, disponemos de evidencias sólidas para cuestionar su independencia organizativa.
18. Las imágenes incrustadas pueden convertirse en otra investigación #
Cuando un redactor inserta una fotografía en un documento de Word o PowerPoint, suele recortarla visualmente dentro del procesador o reducir su tamaño en la página para ajustarla al texto. Sin embargo, en los formatos OOXML, el paquete suele conservar la fotografía original completa sin recortar en la carpeta word/media/.
Al extraer los archivos gráficos directamente del archivo ZIP, el analista obtiene la imagen en su resolución máxima nativa y, en muchas ocasiones, con sus metadatos EXIF íntegros (incluyendo modelo de cámara y coordenadas GPS del autor), los cuales habrían desaparecido si hubiéramos capturado la imagen con un simple pantallazo.
En ese instante, la investigación documental se conecta de forma natural con nuestra guía de OSINT de imágenes: podemos calcular el hash de la fotografía extraída, realizar búsqueda inversa en Google Lens o TinEye y geolocalizar la escena real en mapas satelitales.
19. Las relaciones internas pueden revelar cómo está construido el archivo #
Los archivos Office Open XML gestionan los vínculos entre sus componentes mediante esquemas formales de relaciones ubicados en las carpetas _rels (como word/_rels/document.xml.rels).
Examinar este archivo XML permite descubrir dependencias técnicas que no se aprecian al leer el texto: enlaces a plantillas corporativas alojadas en servidores internos (rutas UNC del tipo file://servidor-interno/plantillas/contratos.dotx), conexiones OLE con hojas de cálculo externas o enlaces a repositorios SharePoint corporativos. Estas rutas pueden desvelar nombres de servidores privados de la red interna, convenciones de nombres de usuario y dominios corporativos ocultos a simple vista.
20. Hipervínculos: quizá la pista más infravalorada #
En el texto formateado de un PDF o de un documento de Word, un hipervínculo puede mostrar visualmente una URL aparentemente inocua, como https://portal-transparencia.org. Sin embargo, el destino real programado en el enlace subyacente puede apuntar a un servidor completamente distinto:
# Texto visible en la página:
https://portal-transparencia.org

# Destino real del hipervínculo interno:
https://servidor-privado.consultora-externa.net/descargas/expediente_borrador.pdf?token=abc123xyz
Revisar sistemáticamente la tabla interna de hipervínculos es una de las prácticas más rentables en OSINT: permite identificar parámetros de seguimiento (UTM tags), identificadores únicos de sesión, plataformas en la nube personales (como cuentas personales de Google Drive o Dropbox) y repositorios de staging donde los documentos fueron alojados antes de su difusión pública.
21. El texto extraído permite buscar frases únicas #
Una vez volcado el contenido textual del documento a texto plano (mediante herramientas como pdftotext para PDF o scripts en Python para DOCX), busca expresiones sintácticas poco comunes entrecomilladas en buscadores web:
"establece las condiciones tecnicas de interoperabilidad para la plataforma de"Si una frase de diez o doce palabras aparece con idéntica redacción en una directiva ministerial previa, en una licitación de otro ayuntamiento o en la tesis doctoral de un investigador, habrás identificado el linaje documental de la obra. Esto permite determinar si estamos ante un trabajo original, una adaptación de una norma estándar o una copia literal de un documento previo.
22. Errores, marcas y peculiaridades también son buscables #
Las frases bien redactadas pueden repetirse en múltiples documentos corporativos estándar. Los errores ortográficos singulares, los fallos tipográficos y las erratas numéricas, en cambio, son firmas analíticas irrepetibles.
Una errata poco común en una palabra técnica, una cifra estadística con un decimal equivocado o un identificador interno de proyecto (por ejemplo: EXP-2025-MOD-88A) constituyen los mejores términos de búsqueda posibles en Google Dorks. Con frecuencia, rastrear una errata concreta en un buscador conduce directamente al documento matriz del que proceden todas las copias derivadas.
23. El documento puede tener una identidad propia (Ficha técnica) #
Cuando investigues un documento con trascendencia probatoria, no confíes en notas desordenadas. Elabora una ficha técnica estandarizada que recopile las dimensiones clave del archivo antes de extraer conclusiones:
| Dimensión analítica | Campo técnico | Ejemplo de valor registrado |
|---|---|---|
| Identificación del archivo | Nombre del fichero y Hash SHA-256 | informe-anual-2026.pdf · e3b0c44298fc1c14... |
| Origen web | URL de descarga y dominio | https://empresa.com/docs/informe.pdf |
| Propiedades métricas | Tamaño y número de páginas | 4.8 MB (5.033.164 bytes) · 48 páginas |
| Atributos de autoría | Author / Creator / Producer | Maria Gonzalez · Word · Adobe PDF Library |
| Marcas temporales | CreationDate / ModDate | 2026-03-02 09:15:00 · 2026-03-04 17:30:00 |
| Primera aparición en red | Fecha en Wayback Machine o buscadores | 2026-03-05 (indexado por Google) |
Esta disciplina metodológica impide que el analista confunda lo que dice el documento en su portada con lo que registra el sistema de archivos o lo que atestigua la red.
24. Tres fechas pueden ser correctas al mismo tiempo #
Considera este escenario analítico frecuente: un informe presenta impresa en su portada la fecha del 1 de marzo de 2026. Sus metadatos internos CreationDate indican el 3 de marzo de 2026. Y los registros del servidor web confirman que el fichero se subió a la web el 5 de marzo de 2026.
Un observador inexperto proclamará inmediatamente que ha descubierto una falsificación documental porque «las fechas no coinciden». Un analista profesional de OSINT comprende que las tres fechas son perfectamente coherentes y legítimas al mismo tiempo:
En lugar de preguntarse de forma simplista «¿Cuál es la fecha verdadera?», el analista riguroso investiga: «¿Qué acontecimiento técnico o administrativo representa cada una de estas tres marcas de tiempo?».
25. Una versión anterior puede ser más interesante que la actual #
Las organizaciones corrigen, actualizan y sustituyen documentos públicos constantemente para enmendar erratas numéricas, ajustar previsiones presupuestarias o suavizar conclusiones comprometidas. Para una investigación, sin embargo, el documento verdaderamente revelador rara vez es la versión final edulcorada: suele ser el borrador previo.
Rastrear versiones anteriores exige consultar herramientas históricas como Wayback Machine de Internet Archive o buscar archivos con nomenclaturas incrementales en el mismo servidor mediante Google Dorks (informe_v1.pdf, informe_borrador.pdf, informe_revisado.pdf). Comparar los cambios introducidos entre versiones permite descubrir exactamente qué información intentó matizar o eliminar la entidad emisora.
26. “Final” es uno de los conceptos menos fiables de informática #
Cualquier profesional que haya gestionado proyectos ofimáticos sabe que la palabra «final» en el nombre de un archivo es un oxímoron informático. Encontramos con pasmosa regularidad secuencias como:
Estrategia_2026_FINAL.docx
Estrategia_2026_FINAL_v2.docx
Estrategia_2026_FINAL_DEFINITIVA.docx
Estrategia_2026_FINAL_BUENA_REVISADA.pdf
Nunca aceptes la palabra final de un título o nombre de archivo como prueba de que estás analizando la versión definitiva y aprobada de un acuerdo. La versión definitiva es únicamente aquella respaldada por una firma digital válida, una publicación en boletín oficial o una acreditación institucional inequívoca en la fuente primaria.
27. Compara documentos, no solamente metadatos #
Cuando dispones de dos versiones de un documento con idéntico título pero fechas o metadatos dispares, no te limites a contrastar las propiedades de archivo en ExifTool. La investigación real exige realizar un cotejo textual y estructural minucioso.
Convierte ambos archivos a texto plano y ejecuta herramientas de comparación diferencial como diff en terminal, o herramientas gráficas como Meld, WinMerge o la función de comparar documentos de LibreOffice y Word. Pregúntate con criterio forense:
- ¿Qué párrafos exactos fueron eliminados, reescritos o reordenados?
- ¿Cambiaron los números de cuenta, los importes presupuestarios o los porcentajes de auditoría?
- ¿Aparecieron páginas anexas o desaparecieron tablas estadísticas completas?
- ¿Se sustituyó el nombre del responsable técnico o la fecha del visado administrativo?
Los metadatos pueden alertarnos de que un archivo ha cambiado; la comparación analítica de contenidos nos explica exactamente por qué cambió y qué implicaciones tiene ese cambio.
28. Los PDF también pueden contener contenido no evidente a simple vista #
La especificación técnica del formato PDF es extraordinariamente rica y compleja: admite capas gráficas superpuestas, objetos vectoriales enmascarados, comentarios ocultos, formularios interactivos y fuentes tipográficas incrustadas.
Esto significa que renderizar el PDF en la pantalla de un visor comercial no equivale a ver la totalidad de la información contenida en el archivo. En muchos casos de desclasificación o filtración mal gestionada, quienes pretenden «censurar» datos confidenciales cometen el error ingenuo de colocar rectángulos negros encima del texto sensible sin rasterizar la página. Al abrir el archivo o extraer su contenido textual con herramientas forenses, el texto oculto debajo del recuadro negro sigue estando íntegro y accesible. Conocer la anatomía interna del formato evita dar por cerrado un análisis que apenas ha comenzado.
29. No abras documentos desconocidos de cualquier manera (OPSEC) #
En el trabajo de fuentes abiertas es imprescindible mantener una estricta disciplina de seguridad operativa (OPSEC). Un archivo ofimático descargado de un canal anónimo de mensajería, un foro no verificado o una supuesta filtración puede albergar exploits dirigidos a vulnerabilidades de día cero en visores PDF o suites ofimáticas.
Aplica siempre estas medidas preventivas en tu laboratorio de análisis:
- Aislamiento de entornos: Abre y procesa documentos no confiables en máquinas virtuales aisladas (VMs) o entornos descartables (sandboxes), nunca en tu máquina de producción personal o corporativa.
- Bloqueo de contenido activo: Jamás habilites la ejecución de macros de VBA o código embebido porque un documento te lo solicite con excusas visuales («Habilite contenido para ver el informe protegido»).
- Inspección estática previa: Extrae primero los metadatos y el texto plano con herramientas de línea de comandos en local (como ExifTool o
strings), sin necesidad de renderizar el archivo en aplicaciones complejas.
30. PDF/A no es simplemente “otro PDF” #
Al investigar documentación procedente de administraciones públicas, juzgados, universidades o archivos históricos, te toparás frecuentemente con el formato PDF/A. Este estándar internacional, normalizado bajo la serie ISO 19005, está específicamente diseñado para garantizar la preservación documental a largo plazo.
A diferencia de un PDF convencional, un archivo PDF/A prohíbe de forma estricta elementos dinámicos que impidan su lectura inmutable en el futuro: prohíbe scripts interactivos de JavaScript, tipografías externas no incrustadas y llamadas a recursos remotos en la red. Además, exige que los metadatos descriptivos estén obligatoriamente incrustados en formato XMP conforme a ISO 16684-1. No obstante, recuerda este matiz crítico: que un documento cumpla con la norma técnica PDF/A no certifica que su contenido sea verdadero ni veraz; acredita que su formato técnico cumple con los requisitos legales de archivo digital a largo plazo.
31. Firma digital y apariencia de firma no son lo mismo #
Un PDF puede mostrar en su última página una imagen digitalizada de una rúbrica manuscrita junto al sello circular de un organismo público. Desde el punto de vista pericial y legal, esa imagen gráfica no tiene ningún valor probatorio criptográfico: cualquier persona puede recortar una firma manuscrita de un documento oficial y pegarla como imagen en otro archivo en cuestión de segundos.
Una verdadera firma electrónica o digital se basa en criptografía asimétrica de clave pública mediante certificados reconocidos (estándares X.509 y PAdES en el marco eIDAS europeo). La firma no es una imagen; es un bloque matemático integrado en el PDF que garantiza dos propiedades irrefutables:
Para comprobar una firma, utiliza el panel de firmas digitales de Adobe Acrobat o validadores administrativos oficiales (como Autofirma o el servicio VALIDe en España), inspeccionando la cadena de confianza del certificado y la marca de tiempo (timestamp) emitida por una Autoridad de Sellado de Tiempo reconocida.
32. Una firma válida tampoco demuestra que todas las afirmaciones sean verdaderas #
Incluso cuando verificas con éxito que un PDF contiene una firma digital formalmente válida y emitida por una personalidad jurídica reconocida, no caigas en la trampa de considerar que cada línea de texto del informe es una verdad fáctica incontestable.
La firma digital certifica que esa persona o entidad estampó su certificado criptográfico sobre ese documento en ese momento exacto y que el archivo no ha sufrido modificaciones posteriores. Pero el firmante puede estar cometiendo un error técnico de buena fe, trasladando datos incorrectos aportados por un tercero o incluso firmando una declaración deliberadamente engañosa. La autenticidad formal del continente y la veracidad objetiva del contenido siguen perteneciendo a esferas analíticas distintas.
33. Metadatos y privacidad: el mismo conocimiento sirve para defender #
Todo el conocimiento metodológico que aplicamos en OSINT para auditar documentos de terceros constituye la mejor herramienta de seguridad defensiva y prevención de fugas de información dentro de nuestras propias organizaciones.
Cuando una empresa o institución publica memorias anuales, licitaciones o notas informativas en su página web sin higienizar previamente sus metadatos, puede estar exponiendo inadvertidamente a los ojos de atacantes y competidores:
- Estructuras de nombres de usuario internos de Active Directory (facilitando ataques de password spraying).
- Rutas locales completas de discos duros y servidores compartidos (revelando la arquitectura de la red interna).
- Versiones de software ofimático y sistemas operativos desactualizados (marcando objetivos para exploits de día cero).
- Comentarios de revisión internos y partes involucradas no anunciadas públicamente.
Antes de publicar cualquier documento institucional en Internet, audítalo con la mirada implacable de un analista de fuentes abiertas y desinféctalo eliminando metadatos innecesarios.
34. Un ejercicio excelente: audita tus propios documentos #
Para interiorizar de forma práctica cómo se generan y mutan los metadatos a lo largo del proceso productivo, no necesitas investigar objetivos de terceros. El mejor entrenamiento consiste en auditar tu propio flujo de trabajo:
Ejercicio de auto-auditoría documental:
- Crea un documento de texto sencillo en Microsoft Word o LibreOffice Writer, añade una imagen de tu teléfono móvil y guárdalo como
prueba.docx. - Abre una terminal y examina sus propiedades con
exiftool prueba.docx. Observa los nombres de usuario y fechas registradas. - Haz una copia como
prueba.zip, descomprímela y leedocProps/core.xmlydocProps/app.xmlen un editor de código. - Exporta el documento original a formato PDF desde la opción nativa del procesador y ejecuta
exiftool -G1 -a -s prueba.pdf. - Compara los metadatos de ambas versiones. Comprobarás con absoluta claridad qué información se hereda, qué campos se transforman y cómo se comporta cada formato en tu entorno real.
35. Qué puede demostrar realmente un metadato #
En informes forenses y análisis de ciberseguridad, el rigor expositivo y la precisión del lenguaje marcan la diferencia entre un trabajo pericial creíble y una conjetura desestimable. Aplica siempre esta correspondencia estricta entre el dato observado y la afirmación analítica admitida:
| Metadato observado | Conclusión analítica válida y rigurosa | Conclusión errónea o precipitada |
|---|---|---|
Creator: Microsoft Word |
El campo técnico Creator indica que el archivo se originó en esa aplicación. | «El redactor utilizó Microsoft Word para escribir la totalidad del informe.» |
Author: Carlos |
La propiedad Author del documento almacena la cadena de caracteres «Carlos». | «Carlos es el autor intelectual que redactó este documento.» |
CreationDate: 2026-06-01 |
El archivo declara técnicamente haber sido generado en esa fecha y hora. | «El informe fue redactado e investigado el 1 de junio de 2026.» |
ModDate != CreationDate |
El documento sufrió un proceso de reescritura o guardado técnico posterior. | «El documento fue manipulado de forma fraudulenta para alterar su contenido.» |
36. Correlacionar varios documentos puede revelar patrones #
El verdadero potencial del OSINT documental se manifiesta cuando dejamos de mirar un archivo aislado y procedemos a analizar colecciones masivas de documentos de una misma entidad.
Si descargas mediante scraping legítimo o Google Dorks cien archivos PDF publicados por una corporación a lo largo de cinco años y extraes sus metadatos de forma automatizada mediante un script en Python con ExifTool, emergerán patrones organizativos extraordinarios: identificarás qué departamentos utilizan sistemas Linux y cuáles Windows, qué consultoras externas redactan pliegos confidenciales antes de ser publicados oficialmente o qué cambios de directiva coinciden con modificaciones masivas en las plantillas ofimáticas institucionales.
37. El error más peligroso: buscar una persona y encontrarla porque querías encontrarla #
El sesgo de confirmación es el mayor enemigo del analista de inteligencia. Imagina que en una investigación sospechas previamente que un empleado llamado Juan es el autor de una filtración interna. Ejecutas ExifTool sobre el archivo filtrado y lees: LastModifiedBy: Juan. El impulso humano básico es dar por cerrado el caso y proclamar la culpabilidad de Juan.
Un analista profesional frena en seco y formula preguntas escépticas: ¿Tiene la empresa más de un empleado llamado Juan? ¿Pudo Juan haber sido el diseñador que creó la plantilla corporativa utilizada por cientos de compañeros? ¿Pudo un tercero haber utilizado el equipo de Juan en un descuido? En inteligencia de fuentes abiertas, una coincidencia no es una condena; es solo una hipótesis que debe ser refutada implacablemente antes de ser aceptada.
38. OSINT documental aplicado a empresas #
En el ámbito de la investigación corporativa, los documentos descargables son una mina de oro. Las memorias de responsabilidad social (ESG), las presentaciones para inversores, los catálogos técnicos de productos y los folletos comerciales albergan información estratégica de primer nivel.
En este punto, el análisis documental enlaza directamente con nuestra guía de OSINT de empresas y organizaciones: cruzando los nombres de directivos que figuran en las propiedades de los documentos con registros mercantiles, patentes y licitaciones públicas, podemos reconstruir el organigrama funcional y la red societaria de cualquier entidad en fuentes abiertas.
39. Documentos académicos: una categoría propia #
Los artículos científicos, memorias técnicas de investigación y papers académicos poseen una taxonomía documental especializada. Suelen incorporar identificadores digitales persistentes como DOI (Digital Object Identifier), registros ORCID de los investigadores y enlaces normalizados a repositorios de preprints (como arXiv o Zenodo).
En estos casos, el análisis del archivo local se complementa con consultas a bases de datos bibliométricas abiertas como Crossref, OpenAlex, Semantic Scholar y Google Scholar. Como abordamos extensamente esa metodología en nuestra guía específica de herramientas OSINT para papers y fuentes académicas, aquí nos centramos en el documento como evidencia y artefacto digital.
40. La fuente primaria sigue siendo más importante que el PDF bonito #
Un documento en formato PDF puede lucir una presentación visual impecable: tipografías corporativas elegantes, membretes institucionales de alta resolución, sellos oficiales y una maquetación profesional que transmita una indiscutible apariencia de autoridad técnica.
Nada de eso reemplaza la pregunta primaria de toda investigación de fuentes abiertas: ¿Dónde y cómo fue obtenido este archivo? Un documento descargado directamente del portal de transparencia de un ministerio posee una cadena de custodia y un contexto indiscutibles; ese mismo PDF distribuido en un archivo comprimido en una red social anónima carece de respaldo verificable. El diseño gráfico nunca sustituye a la fuente primaria.
41. Caso práctico ficticio: “Informe estratégico 2026” #
Para consolidar la aplicación real de estos conceptos, analicemos un escenario ficticio pero completamente representativo de las verificaciones que realizamos habitualmente en entornos periciales:
Fase 1: Planteamiento y presunta filtración
Se difunde en redes sociales un archivo titulado Informe_Estrategico_2026.pdf con el logotipo oficial de una gran corporación de telecomunicaciones. El mensaje que lo acompaña afirma de forma sensacionalista: «Documento interno confidencial filtrado esta misma mañana revelando despidos masivos».
Fase 2: Verificación de título y búsqueda de copias
En lugar de abrir el archivo a ciegas, extraemos el título exacto de la portada y lo buscamos entrecomillado en buscadores con operadores avanzados. Descubrimos que el título corresponde exactamente a una memoria pública presentada ante la Comisión Nacional del Mercado de Valores hace dos meses. La premisa de «filtración secreta e inédita» queda inmediatamente en entredicho.
Fase 3: Comparación criptográfica y de versiones
Descargamos la copia oficial del portal del regulador y calculamos los hashes SHA-256 de ambos ficheros. Los valores difieren: estamos ante dos archivos físicamente distintos. Al cotejar la paginación, comprobamos que el archivo recibido tiene 4 páginas adicionales al final que no figuran en el documento oficial.
Fase 4: Análisis de metadatos y contenido añadido
Ejecutamos ExifTool sobre el archivo recibido. La fecha CreationDate coincide exactamente con el documento oficial (12 de julio de 2026), pero el campo ModDate refleja una modificación guardada ayer con un software gratuito de edición de PDF. Extraemos el texto de las 4 páginas añadidas: descubrimos que coinciden literalmente con un comunicado sindical antiguo de 2022 sobre otra empresa distinta.
Fase 5: Conclusión probatoria y dictamen
El dictamen analítico concluye con absoluta certeza probatoria: el archivo analizado es un montaje documental que añade cuatro páginas descontextualizadas de 2022 sobre una memoria financiera pública y legítima de 2026, con el propósito de generar alarma en el mercado. La afirmación de filtración confidencial queda totalmente refutada con evidencias objetivas.
42. Workflow completo para investigar un documento #
Para asegurar que ninguna línea de investigación quede desatendida, sigue este protocolo secuencial estructurado en 13 fases analíticas:
El orden exacto puede adaptarse según las particularidades de cada caso, pero el principio ético rector permanece inalterable: ninguna herramienta informática sustituye al razonamiento escéptico del investigador.
43. Herramientas que realmente merece la pena conocer #
En el ecosistema del análisis documental de fuentes abiertas no se necesitan cientos de programas redundantes. Se necesita dominar un conjunto selecto de herramientas especializadas sabiendo exactamente qué problema resuelve cada una:
| Necesidad técnica de investigación | Herramienta o técnica recomendada | Utilidad operativa principal |
|---|---|---|
| Localizar documentos en la web | Google / Bing Dorks (filetype:) |
Descubrir archivos indexados en dominios corporativos e institucionales. |
| Extracción forense de metadatos | ExifTool (Phil Harvey) | Lectura exhaustiva de metadatos PDF, Office, imágenes y formatos propietarios. |
| Inspección rápida de cabeceras PDF | pdfinfo (Poppler) | Extracción limpia de propiedades básicas, tamaños de página y seguridad. |
| Extracción de texto estructurado | pdftotext (Poppler) / Python | Conversión de documentos a texto plano para búsqueda de frases y minería de datos. |
| Certificación de integridad | sha256sum / Get-FileHash | Generación de firmas criptográficas para garantizar la cadena de custodia. |
| Auditoría interna de DOCX/XLSX/PPTX | Descompresión ZIP + XML | Inspección de core.xml, app.xml, relaciones y medios incrustados. |
| Comparación diferencial de textos | diff / WinMerge / Meld | Cotejo línea por línea de cambios introducidos entre borradores y versiones finales. |
| Localización de versiones históricas | Wayback Machine / Google Cache | Recuperación de versiones anteriores de archivos retirados o modificados en la web. |
| Análisis de fotografías incrustadas | Extracción de medios + Búsqueda Inversa | Verificación de imágenes originales con Google Lens y análisis de coordenadas GPS. |
| Validación de documentos científicos | Crossref / OpenAlex / Google Scholar | Comprobación de identificadores DOI, citas cruzadas y perfiles de investigación. |
| Verificación de firmas electrónicas | Adobe Acrobat Reader / Autofirma | Comprobación criptográfica de certificados X.509, sellos de tiempo y validez PAdES. |
44. Errores frecuentes al hacer OSINT con documentos #
Para evitar fallos de bulto en tus investigaciones, mantén siempre presentes estas trampas recurrentes:
- Fetichismo tecnológico: Asumir que porque un metadato parece complejo o proviene de una consola de comandos es automáticamente verdadero e inalterable.
- Confusión de autoría: Equiparar el nombre que figura en la etiqueta
Authorcon el redactor intelectual real del informe. - Literalidad temporal: Tratar la fecha de creación técnica del fichero (
CreationDate) como el día en que se escribió el texto. - Pérdida de contexto: Analizar un archivo suelto reenviado por mensajería sin documentar de qué página o enlace se descargó originalmente.
- Negligencia OPSEC: Abrir archivos de procedencia desconocida en máquinas personales habilitando macros o JavaScript.
- Miopía de versión única: Conformarse con la versión actual del documento e ignorar el rastreo de borradores previos en archivos históricos.
- Enamoramiento de la anécdota: Obsesionarse con un metadato curioso o llamativo que no aporta nada para responder a la pregunta de la investigación.
45. Construye conclusiones por niveles #
Para mantener una impecable solidez pericial, acostumbra a redactar tus informes separando con nitidez cada plano de conocimiento analítico:
1. Hecho observado (Dato objetivo incontrovertible)
El metadato dc:creator del archivo analizado contiene la cadena de texto "M. Garcia" y el campo CreationDate registra 2026-02-10.
2. Interpretación técnica
El documento fue generado técnicamente en un equipo donde la aplicación ofimática estaba registrada a nombre de ese identificador.
3. Hipótesis de trabajo
M. García podría ser el redactor original del texto o el propietario de la plantilla corporativa sobre la que se estructuró el informe.
4. Corroboración independiente (Conclusión fundada)
Se localiza en el organigrama oficial de la empresa que Manuel García es el Director de Auditoría Técnica y figura como firmante en la nota de prensa de presentación del informe.
46. Ausencia de metadatos no significa ausencia de historia #
Si ejecutas ExifTool sobre un documento y compruebas que ha sido completamente desinfectado y no conserva una sola etiqueta de metadatos, no des por cerrada la investigación. Los metadatos son solo una de las múltiples dimensiones analíticas de un archivo.
Aún dispones de infinidad de fuentes de evidencia: el análisis tipográfico, las marcas de agua sutiles, los enlaces y rutas web incrustadas en el texto, los códigos de expedientes normativos, las fechas de indexación en servidores públicos, la hemeroteca en Internet Archive y las relaciones cruzadas con otros documentos de la misma organización. Un documento despojado de metadatos sigue teniendo una historia esperando ser investigada.
47. Una buena investigación puede terminar con “no lo sabemos” #
En el ámbito del peritaje y la inteligencia de fuentes abiertas, la honestidad intelectual es el valor supremo. Si tras un análisis exhaustivo el documento resulta ser anónimo, carece de metadatos válidos, no está firmado y no se localiza una fuente primaria creíble, la única conclusión admisible y rigurosa es:
«Con las evidencias técnicas y documentales disponibles hasta la fecha, no es posible determinar de forma concluyente la autoría ni la autenticidad del documento.»
Concluir con un prudente «no lo sabemos con certeza» no es un fracaso investigativo; es la muestra de profesionalidad que separa al analista riguroso de quien inventa relatos para complacer expectativas.
Preguntas frecuentes sobre OSINT de documentos #
¿Qué es OSINT de documentos? #
Es la aplicación metódica de técnicas de Inteligencia de Fuentes Abiertas a archivos documentales (PDF, Office, etc.) para verificar su procedencia, autenticidad, autoría técnica, historia de modificaciones y contexto mediante evidencias públicas.
¿Qué metadatos puede tener un PDF? #
Un PDF puede almacenar propiedades estándar como título, autor, asunto, palabras clave, fecha de creación, fecha de modificación, software creador (Creator) y conversor (Producer), además de flujos estructurados XMP bajo norma ISO 16684-1.
¿Cómo puedo ver los metadatos de un PDF? #
La herramienta de referencia profesional es ExifTool, ejecutando exiftool -G1 -a -s documento.pdf en consola. También pueden utilizarse utilidades de código abierto como pdfinfo o visores comerciales de PDF.
¿Cómo puedo ver los metadatos de un Word? #
Puedes consultar las propiedades de archivo desde Microsoft Word o LibreOffice, ejecutar exiftool documento.docx o descomprimir el contenedor OOXML y revisar directamente el archivo docProps/core.xml.
¿Un DOCX es un archivo ZIP? #
Sí. Todos los formatos modernos de Office Open XML (DOCX, XLSX, PPTX) son contenedores ZIP estandarizados que empaquetan archivos XML estructurados, hojas de estilos e imágenes incrustadas en su resolución original.
¿Los metadatos permiten saber quién creó un documento? #
Aportan una pista inicial de gran valor, pero no demuestran por sí solos la autoría intelectual. El campo Author puede proceder de una plantilla corporativa, de un perfil de usuario compartido o de una exportación automatizada.
¿La fecha de creación del PDF demuestra cuándo fue escrito? #
No. El campo CreationDate registra cuándo se generó la representación técnica del archivo PDF, no cuándo se redactó el texto intelectual, que pudo haber sido escrito con semanas o meses de antelación.
¿Qué es XMP? #
Es la plataforma de metadatos extensibles (Extensible Metadata Platform), un estándar internacional (ISO 16684-1) promovido por Adobe para incrustar metadatos estructurados en XML dentro de múltiples formatos de archivo digital.
¿Cómo encontrar PDFs de una empresa? #
Combinando operadores avanzados de búsqueda en Google o Bing, por ejemplo: site:empresa.com filetype:pdf, y añadiendo términos clave temáticos como «informe», «balance» o «auditoría».
¿Cómo sé si dos documentos son iguales? #
Calculando sus huellas criptográficas SHA-256. Si ambos hashes son idénticos bit a bit, los archivos son exactamente iguales. Si difieren, debes realizar una comparación diferencial para identificar qué texto o metadato cambió.
¿Se puede investigar un Excel con OSINT? #
Sí. Las hojas de cálculo XLSX albergan metadatos en core.xml, fórmulas vinculadas, hojas de cálculo ocultas, comentarios de celdas y conexiones a orígenes de datos externos que aportan un inmenso valor probatorio.
¿Los documentos pueden revelar nombres de usuarios? #
Con mucha frecuencia. Los metadatos de documentos no higienizados pueden desvelar nombres de usuarios de red en los campos de autor, revisor o en las rutas locales de almacenamiento de plantillas.
¿Es seguro abrir cualquier documento que encuentro en Internet? #
No. Documentos de procedencia desconocida pueden contener macros maliciosas o aprovechar vulnerabilidades en el visor. Analízalos siempre en entornos aislados (sandbox o máquina virtual) y sin habilitar contenido activo.
¿Cuál es la mejor herramienta para analizar metadatos? #
ExifTool es la solución más potente, completa y versátil para extraer metadatos de cientos de formatos en local sin comprometer la confidencialidad de tus archivos en servidores externos.
Conclusión: un documento tiene más de una historia #
Cuando un lector común abre un archivo PDF en su ordenador, solo ve páginas y texto formateado. Cuando un analista de fuentes abiertas examina ese mismo archivo, descubre una estructura viva compuesta por capas superpuestas: una URL de origen, una firma criptográfica, metadatos ofimáticos, herramientas generadoras, marcas temporales y dependencias técnicas.
Ninguna de estas piezas resuelve una investigación por sí sola, pero cuando se triangulan con rigor, nos permiten reconstruir cómo nació el documento, qué manos intervinieron en su creación, cómo evolucionó en el tiempo y qué historia real pretendían contar sus autores. En OSINT documental no necesitamos acumular cientos de herramientas exóticas: necesitamos formular mejores preguntas y buscar evidencias contrastables.
Continúa aprendiendo OSINT y análisis técnico #
El análisis documental forma parte de un ecosistema interdisciplinar de investigación técnica en fuentes abiertas. Amplía tus conocimientos con nuestras guías especializadas:
- Domina la localización de archivos no indexados con nuestra guía de Google Dorks para OSINT: búsqueda avanzada y operadores.
- Aprende a rastrear personas jurídicas y contratos en el manual de OSINT de empresas: cómo investigar organizaciones.
- Si el documento contiene fotografías o esquemas gráficos, continúa con OSINT de imágenes: búsqueda inversa y geolocalización.
- Para literatura científica y fuentes bibliográficas, consulta Herramientas OSINT para Papers y Fuentes Académicas.
- Descubre los itinerarios de formación práctica en nuestra ruta de Red Team y Hacking Ético.
Fuentes técnicas principales #
Esta guía ha sido contrastada con la documentación técnica de Phil Harvey sobre ExifTool, las especificaciones de la PDF Association sobre PDF/A y XMP, los estándares ISO 16684-1 e ISO 19005, y las directrices técnicas de Microsoft sobre estructuras Office Open XML.
Última revisión técnica: 21 de septiembre de 2026.